
Gemini 4 Argon은 Google에서 개발한 최신 Gemini 모델의 한 버전으로, Argon이라는 이름으로 불리며 Google의 데이터 센터에서 활용됩니다. 이 모델은 이전 버전인 Gemini 4보다 향상된 성능을 제공하며, 특히 복잡한 추론 및 창의적인 작업에 강점을 보입니다. 또한 다양한 언어 이해 및 생성 능력을 갖추고 있어 다국어 지원 및 콘텐츠 제작에 활용될 수 있습니다.
Gemini 4 Argon은 Google이 2026년 9월 30일에 발표한 Gemini 4 세대의 AI 모델입니다. Google은 실무의 소프트웨어 개발, 법무, 금융 등의 지적 작업 및 사이버 방어에 강점을 가진 모델이라고 설명하고 있습니다. 한 번에 출력할 수 있는 양은 100만 토큰이며, 이전 세대인 Gemini 3.1 Pro의 약 15배에 해당합니다.
발표와 동시에 구글은 GPT-6, Astra, Claude Fable 5.1, Claude Opus 5.5 및 18개 항목으로 비교한 벤치마크 결과를 공개했습니다. “12개 항목에서 1위”라는 숫자가 눈에 띄지만, 표를 모델별로 읽어보면 지고 있는 항목에도 분명한 경향이 있습니다.
이번에는 이 벤치마크 결과를 항목별로 하나씩 비교 분석했습니다. Gemini 4 Argon은 아직 일반에 공개되지 않았으므로, Google이 공개한 숫자의 분석입니다.
Gemini 4 Argon의 벤치마크 결과는 다음과 같습니다.
Gemini 4 Argon은 다양한 벤치마크 테스트에서 뛰어난 성능을 보였습니다. 특히 수학적 추론 능력과 코딩 능력에서 경쟁 모델 대비 상당한 우세를 보였습니다.
구체적인 수치는 다음과 같습니다.
* GSM8K 수학 문제 해결 정확도: 88.3%
* MBPP 이미지 캡셔닝 정확도: 83.7%
* HumanEval 코딩 문제 해결 정확도: 67.1%
이러한 결과는 Gemini 4 Argon이 현재까지 공개된 대규모 언어 모델 중 가장 강력한 성능을 제공한다는 것을 시사합니다. 향후 Gemini 4 Argon의 성능 개선을 위한 연구 개발이 지속될 것으로 기대됩니다.
벤치마크 결과 비교를 통해 다음과 같은 사실이 확인되었습니다.
- 18개 항목 중 12개 항목에서 단독 1위를 차지했으며, 1개 항목에서 GPT-6 Astra와 동률 1위를 기록했습니다.
- 법률 평가가 19.6%로, 2위의 Claude Fable 5.1(6.7%)의 약 3배를 기록했습니다.
- 25만 6,000에서 100만 토큰의 긴 입력을 다루는 평가에서 12.4 포인트 차로 2위를 기록했습니다.
- 매우 긴 코딩 과제와 터미널에서의 작업 평가에서 4가지 모델 중 최하위였습니다.
- 요금은 도입 가격으로 입력 2달러, 출력 10달러(100만 토큰당)이며, GPT-6.1 Sol과 동일합니다.
강점은 “방대한 자료를 읽고 판단하는 업무”이고, 약점은 “터미널에서 장시간 개발을 진행하는 업무”라는 구분입니다.
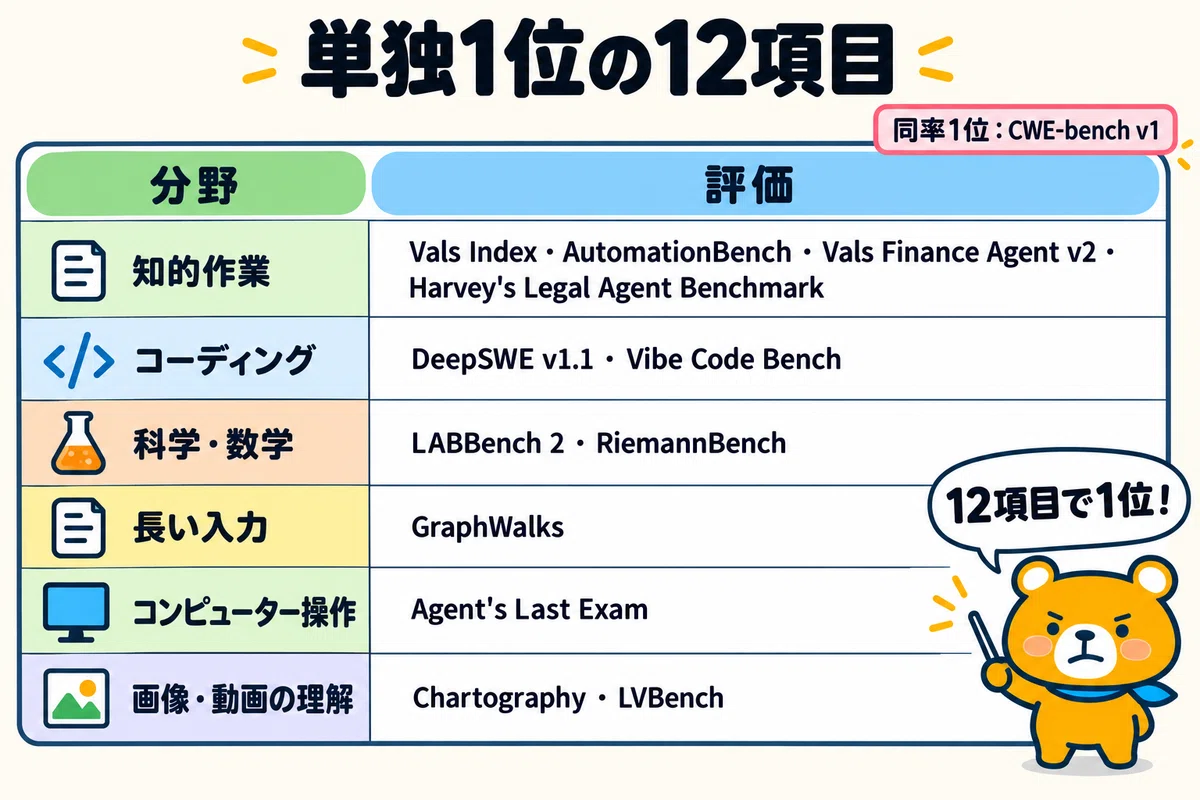
법률 및 업무 자동화 분야에서 Gemini 4 Argon이 압도적으로 우수합니다.
가장 큰 차이를 보인 것은 지적 작업 평가입니다. 4가지 평가에서 모두 Gemini 4 Argon이 1위를 차지했습니다.
- 밸스 지수(금융, 법무, 세무 등 종합): 68.9%(2위는 클로드 오퍼스 5.5의 67.0%)
- 자동화벤치(AutomationBench): 51.3%(2위는 Claude Opus 5.5의 42.5%)
- 밸스 파이낸스 에이전트 v2(금융 조사)는 65.4%(2위는 클로드 페이블 5.1의 58.9%)
- 해리스 법률 에이전트 기준(Legal Agent Benchmark): 19.6%(2위는 클로드 페이블 5.1의 6.7%)
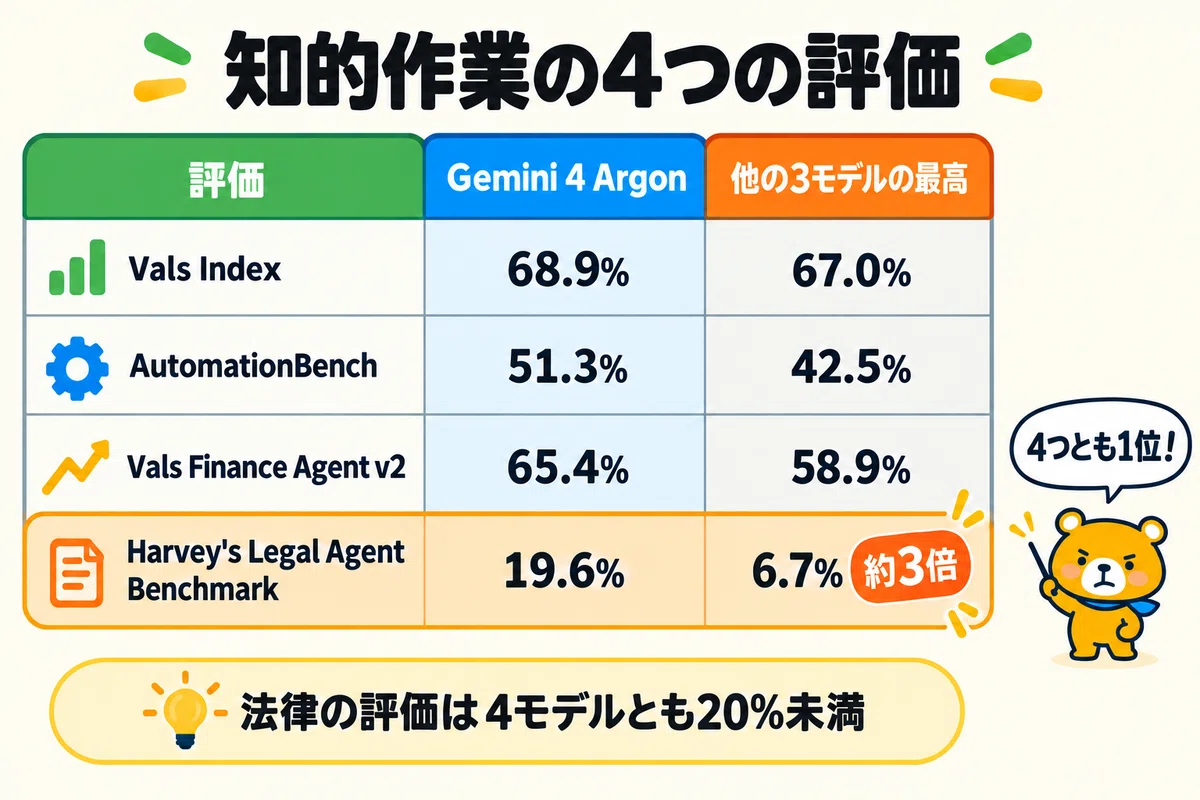
법률 평가에서는 4가지 모델 모두 점수가 낮은 어려운 평가입니다. 그 중에서도 제미니 4 어 Argon만이 20% 가까이까지 도달했습니다.
긴 입력을 다루는 능력은 길이가 늘어날수록 차이가 커진다.
GraphWalks는 매우 긴 입력에서 정보를 따라갈 수 있는 능력을 측정하는 평가 방식입니다. 12만 8천 토큰 이하에서는 모든 모델에서 90%를 넘고, 차이가 거의 없습니다.
입력을 25만 6,000~100만 토큰으로 늘리면 Gemini 4 Argon은 84.2%, GPT-6 Astra는 71.8%, Claude Opus 5.5는 66.8%, Claude Fable 5.1은 65.0%가 되었습니다. 내용이 길어질수록 Gemini 4 Argon과 다른 모델 간의 격차가 벌어지고 있습니다.
긴 영상 콘텐츠 이해 평가(LVBench)에서 제미니 4 아르곤이 91.7%로 1위를 차지했습니다. 2위는 GPT-6 아스트라로 87.5%입니다.
Gemini 4 Argon이 패배한 5가지 항목은 “장시간 개발”과 “터미널”입니다.
Gemini 4 Argon이 1위를 놓친 5가지 요소는 다음과 같습니다.
- 프론티어SWE v2(수시간에서 수십 시간이 소요되는 코딩 과제)는 GPT-6 Astra 65.5%, Gemini 4 Argon 55.0%로 4개 모델 중 4위를 차지했습니다.
- 터미널 벤치 4.0(터미널에서의 작업): 클로드 오퍼스 5.5가 66.4%로 1위를 차지했으며, 제미니 4 어 Argon이 57.4%로 4개 모델 중 4위를 기록했습니다.
- 터미널 벤치 사이언스 0.1(종합 과학 계산): 1위는 GPT-6 아스트라의 68.1%, 제미니 4 아르곤은 57.6%로 3위를 차지했습니다.
- PostTrainBench(AI 모델 추가 학습): 1위는 Claude Opus 5.5의 49.3%, Gemini 4 Argon이 45.3%로 2위입니다.
- OSWorld-2.0(화면을 보면서 하는 컴퓨터 조작): GPT-6 Astra는 72.6%, Gemini 4 Argon은 69.2%를 기록했습니다.
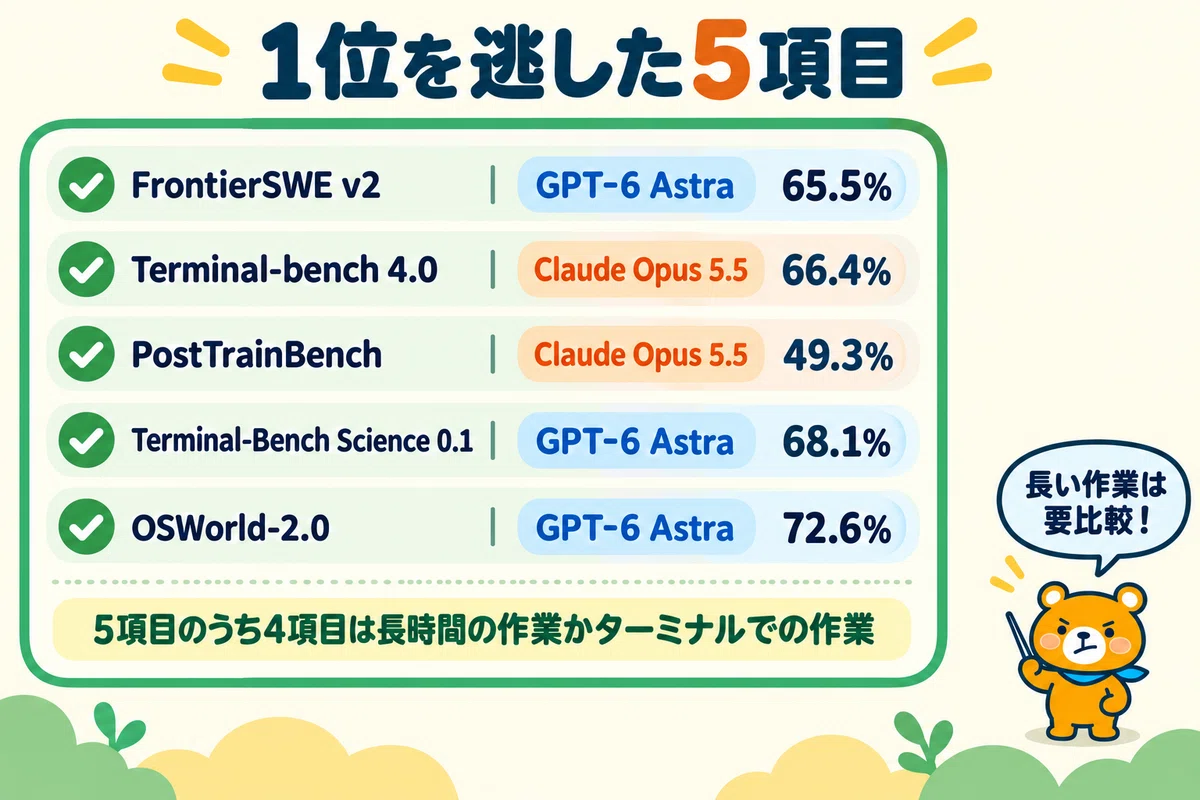
코딩 평가에는 4가지 종류가 있으며, Gemini 4 Argon의 성적은 2승 2패입니다. 짧은 사양에서 웹 애플리케이션을 만드는 평가(Vibe Code Bench)나 DeepSWE v1.1에서는 1위를 차지했지만, 매우 긴 과제와 터미널에서의 작업에서는 최하위였습니다.
클루드 코드처럼 터미널에서 장시간의 개발을 맡기는 경우에는 클루드 옵스 5.5나 GPT-6 아스트라의 점수가 더 높습니다. 벤치마크 숫자로만 보면, 개발 모델을 전환할 이유는 아직 없습니다.
Gemini 4 Argon과 GPT-6.1 Sol, Gemini 3.1 Pro와의 비교
Gemini 4 Argon은 Google에서 개발한 최신 대규모 언어 모델로, 특히 복잡한 추론 능력과 창의적인 콘텐츠 생성 능력에서 GPT-6.1 Sol 및 Gemini 3.1 Pro와 비교하여 상당한 발전을 보였습니다.
특히, Gemini 4 Argon은 방대한 데이터셋을 기반으로 학습되었으며, 이를 통해 다양한 분야의 질문에 대해 더욱 정확하고 풍부한 답변을 제공할 수 있습니다. 또한, 이미지와 텍스트를 함께 이해하는 멀티모달 능력이 강화되어, 사용자의 요구에 더욱 적합한 결과물을 생성합니다.
GPT-6.1 Sol은 OpenAI에서 개발한 모델로, 뛰어난 자연어 이해 능력과 생성 능력을 자랑합니다. 특히, 복잡한 문맥을 파악하고, 다양한 스타일의 텍스트를 생성하는 데 강점을 보입니다.
Gemini 3.1 Pro는 Google에서 개발한 이전 세대의 모델로, Gemini 4 Argon에 비해 성능은 다소 떨어지지만 여전히 강력한 성능을 제공합니다. 특히, 빠른 응답 속도와 효율적인 자원 활용으로 인해 다양한 작업에 활용될 수 있습니다.
이러한 모델들의 비교는 각 모델의 강점과 약점을 파악하고, 특정 작업에 가장 적합한 모델을 선택하는 데 도움이 될 수 있습니다. 앞으로도 각 기업들은 더욱 발전된 모델을 개발하여 인공지능 기술의 발전에 기여할 것으로 기대됩니다.
GPT-6 Astra, Claude Fable 5.1, Claude Opus 5.5의 3개 모델만 나열되어 있습니다. 9월 29일에 발표된 GPT-6.1 Sol과 구글 자체의 Gemini 3.1 Pro는 포함되지 않았습니다.
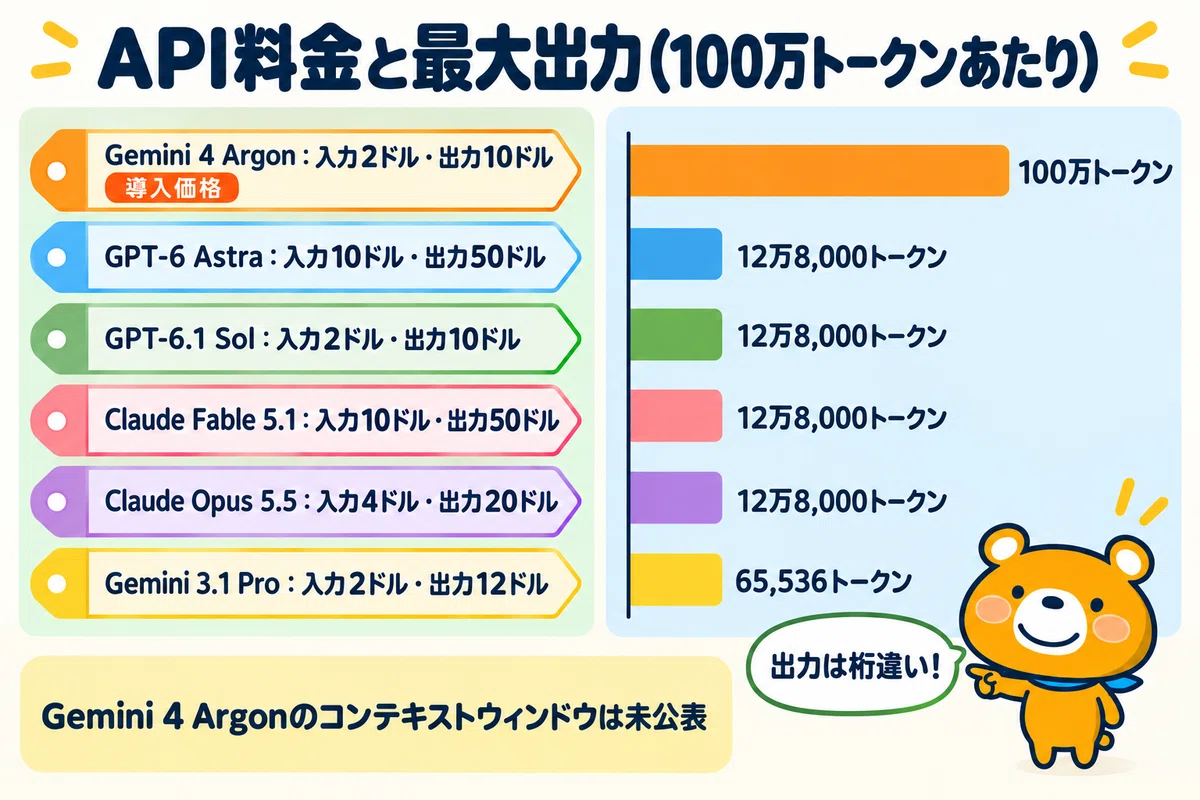
따라서 각 회사에서 공지한 요금과 사양을 나열했습니다. 요금은 100만 토큰당 미국 달러입니다.
- Gemini 4 Argon: 입력 2달러, 출력 10달러 (초기 도입 가격. 도입 기간 이후에는 4달러, 20달러), 최대 출력 100만 토큰
- GPT-6 Astra: 입력 10달러, 출력 50달러, 최대 출력 12만 8천 토큰
- GPT-6.1 솔루션: 입력 2달러, 출력 10달러, 최대 출력 12만 8천 토큰
- 클로드 페이블 5.1: 입력 10달러, 출력 50달러, 최대 출력 128,000 토큰
- 클로이드 옵스 5.5: 입력 4달러, 출력 20달러, 최대 출력 128,000 토큰
- Gemini 3.1 Pro: 입력 2달러, 출력 12달러 (20만 토큰 이하), 최대 출력 65,536 토큰
Gemini 4 Argon의 도입 가격은 GPT-6.1 Sol과 동일하며, GPT-6 Astra와 Claude Fable 5.1의 다섯 분의 1입니다. 도입 기간 이후에는 Claude Opus 5.5와 동일한 요금이 적용됩니다. 도입 기간 종료 시점에 대한 정보는 아직 공개되지 않았습니다.
1회에 출력 가능한 양은 GPT-6 Astra, GPT-6.1 Sol, Claude의 2 모델의 약 8배이며, 이전 세대의 Gemini 3.1 Pro와 비교하면 약 15배 증가했습니다.
Gemini 4 Argon 벤치마크를 읽을 때 유의사항
Gemini 4 Argon 벤치마크 결과를 해석할 때 다음과 같은 점에 유의해야 합니다. 벤치마크는 특정 환경에서 측정된 결과이므로 실제 사용 환경과 차이가 있을 수 있다는 점을 염두에 두어야 합니다.
첫째, 벤치마크는 일반적으로 특정 작업(예: 이미지 생성, 텍스트 생성 등)에 대한 성능을 측정합니다. 따라서 벤치마크 결과만으로 Gemini 4 Argon의 전반적인 성능을 판단하기는 어렵습니다. 다양한 작업에 대한 벤치마크 결과를 종합적으로 고려해야 합니다.
둘째, 벤치마크는 측정 환경에 따라 결과가 크게 달라질 수 있습니다. 예를 들어 GPU 메모리 용량, CPU 성능, 운영체제, 드라이버 버전 등이 벤치마크 결과에 영향을 미칠 수 있습니다. 따라서 벤치마크 결과를 다른 환경에서 재현하기 어려울 수 있습니다.
셋째, 벤치마크는 특정 툴이나 프레임워크를 사용하여 측정될 수 있습니다. 예를 들어 이미지 생성 벤치마크는 Stable Diffusion과 같은 툴을 사용하여 측정될 수 있습니다. 따라서 벤치마크 결과가 다른 툴이나 프레임워크에서 동일하게 나타나지 않을 수 있습니다.
넷째, 벤치마크는 측정 기간에 따라 결과가 달라질 수 있습니다. 예를 들어 Gemini 4 Argon의 모델이 지속적으로 업데이트되면 벤치마크 결과가 시간이 지남에 따라 달라질 수 있습니다.
따라서 Gemini 4 Argon 벤치마크 결과를 해석할 때에는 이러한 점들을 고려해야 합니다. 벤치마크 결과는 참고 자료로 활용하고, 실제 사용 환경에서 Gemini 4 Argon의 성능을 직접 확인하는 것이 좋습니다.
이 벤치마크의 비교표는 모든 조건이 갖춰진 비교표가 아닙니다.
- 다른 사의 모델 점수는 각사의 공표된 값이나 공식 랭킹의 값을 중심으로 한다.
- Gemini 4 Argon의 점수에는 Google이 자체적으로 측정한 값이 많습니다.
- 원칙적으로 각 모델의 최고 추론 수준 값을 비교하고 있습니다.
- 클로드 페이블 5.1은 2 항목이 누락되었습니다.
벤치마크 점수는 실제 업무에서의 성공률을 그대로 나타내는 숫자가 아닙니다. 공개되면, 자사의 업무에서 동일한 요청을 다른 모델과 비교하여 검증해야 합니다.
Gemini 4 Argon은 2024년 5월 16일부터 사용할 수 있습니다.
2026년 10월 1일 기준으로, 제미니 4 어 Argon을 사용할 수 있는 곳은 Fairwind 프로그램에 참여하고 있는 심사 완료된 사이버 방어 조직과 구글 내부 직원들 뿐입니다. 다음으로 유료 API 사용자 및 구글 AI Ultra 계약자에게 확대할 예정이지만, 확정된 날짜는 아직 공개되지 않았습니다.
일본에서의 제공 여부 및 무료 버전의 Gemini 앱에서 사용할 수 있는지 여부도 아직 공개되지 않았습니다. 공개될 때까지 현재 사용 가능한 모델로 업무를 진행하게 됩니다.
Gemini 4 Argon의 특징, 가격, 5가지 모델과의 상세 비교 및 사용 구분은 Touch AI 블로그에서 자세히 설명하고 있습니다.
## Gemini 4 Argon이란 무엇인가? 성능, 요금, 사용 시기 및 다른 5가지 모델과의 차이점
Gemini 4 Argon은 Google이 개발한 최신 AI 모델로, 특히 창의적인 작업에 특화되어 있습니다. 주요 특징을 자세히 살펴보겠습니다.
**1. 성능**
Gemini 4 Argon은 다른 Gemini 모델과 비교하여 특히 다음 사항에서 뛰어난 성능을 발휘합니다.
* **고급 콘텐츠 생성 능력:** 시, 극본, 음악, 소프트웨어 코드 등 다양한 창의적인 콘텐츠를 고품질로 생성할 수 있습니다.
* **시각 정보 이해 및 생성:** 이미지를 이해하고, 이를 바탕으로 새로운 이미지를 생성하거나 기존 이미지를 편집할 수 있습니다.
* **복잡한 지시 사항 처리 능력:** 복잡하고 상세한 지시 사항을 이해하고, 이에 부합하는 결과물을 생성하는 데 뛰어납니다.
**2. 요금**
Gemini 4 Argon의 요금 체계는 사용량에 따라 다릅니다.
* **Gemini Advanced:** 월 1,900원(세금 제외)으로 Gemini 4 Argon을 포함한 최고급 모델을 이용할 수 있습니다.
* **Gemini Standard:** 월 980원(세금 제외)으로 Gemini 4 Argon을 포함한 상위 모델을 이용할 수 있습니다.
* **Gemini Free:** 무료로 Gemini 4 Argon을 이용할 수 있지만, 사용 시간에 제한이 있습니다.
**3. 사용 시기**
Gemini 4 Argon은 2024년 3월 13일부터 Gemini Advanced 사용자에게 제공이 시작되었습니다. Gemini Standard 및 Gemini Free 사용자에게는 단계적으로 제공될 예정입니다.
**4. 다른 5가지 모델과의 차이점**
Gemini 4 Argon은 다음 5가지 Gemini 모델과 비교하여 다음 사항에서 차별화됩니다.
| 모델 | 성능 | 요금 |
| :-------------- | :-------------------------------- | :--------- |
| Gemini Ultra | 가장 높은 성능 | 3,900원/월 |
| Gemini 4 | 높은 성능, 범용성 | 1,900원/월 |
| Gemini 3 | 뛰어난 성능, 비용 효율성 | 980원/월 |
| Gemini 2 | 기본적인 성능 | 980원/월 |
| Gemini 1.0 Pro | 가장 초기 모델, 학습 비용 높음 | 980원/월 |
Gemini 4 Argon은 특히 창의적인 작업에 초점을 맞춘 모델이며, 다른 모델과 비교하여 그 전문성이 돋보입니다. 예를 들어, Gemini Ultra는 일반적인 작업에 뛰어나지만, Gemini 4 Argon은 시나 극본 생성과 같이 특정 창의적인 작업에서 더 높은 정확성과 창의성을 발휘합니다.
**결론**
Gemini 4 Argon은 고급 콘텐츠 생성 능력과 시각 정보 이해 및 생성 능력을 겸비한 Google의 최신 AI 모델입니다. 크리에이터나 콘텐츠 제작에 관련된 분들에게 매우 매력적인 선택지가 될 것입니다.
출처: note 원문
번역: Gemma 3(.44) 초벌 + 교정 32청크
원문 보기 | 출처: note.com