
9월 18일 현재 절반 정도 사용했고, 19일에 절반 정도 사용하면서 글을 작성한 느낌입니다.
움직임(nimble)에 대해서만 정보만 전달되어 아직 테스트를 진행하지 못했습니다.
하루 동안 교정 작업을 하면서 더욱 늘어났는지 확인하고 건조한 웃음이 터져 나온다.
개인적으로는 일본에서 Modernbert를 기반으로 툴을 만들었던 것을 보고, 매우 궁금합니다.
하지만 지금은 눈앞의 정보를 정리하고 싶습니다.
※ 덧붙입니다. Opencode에서 Jev가 무료 횟수를 이용할 수 있습니다.
LLM을 업무 시스템이나 워크플로우에 통합할 때, 누구나 한 번쯤 다음과 같은 문제에 직면했을 것입니다.
- JSON 형식으로 출력해 달라는 지시가 있었음에도 불구하고, 간헐적으로 파싱 오류로 인해 멈추는 현상이 발생합니다.
- 단지 하나의 진위값 또는 분류 결과만 얻고 싶어도 토큰 생성 완료까지 몇 초를 기다려야 한다.
- 확신도(확률)를 믿고 분기 지었다면, 당당하게 큰 거짓말을 하고 있었을 것이다.
실제로 2026년 현재 AI 워크플로우에서 발생하는 오류의 40% 이상이 “잘못된 모델 출력(파싱 실패 또는 스키마 위반)”에 기인한다고 합니다.
그런 가운데 TypeSafe사가 발표해 큰 화제를 모은 것이 Jev다.
제브는 프롬프트를 생성하는 대신 “비구조적인 상태와 유형 정의된 질문”을 제공하여 단일 단계로 직접 클래스 분류 확률을 반환하는 접근 방식을 취하고 있습니다.
이와 유사하게 “자연어에서 작동하며 타입 안전한 의미적 if 문”과 같은 것.
그러고 나서 발표로부터 며칠 만에 수많은 오픈 소스 재현 프로젝트가 등장했습니다.
하지만 “본고와 오픈 소스 소프트웨어는 무엇이 다른가?”, “어떤 것이 실용적인 수준인가?”라는 정보는 여전히 혼재되어 있다.
찾을수록 더 알 수 없어진다.
그래서 신뢰할 수 있는 1차 정보에만 집중하여 조사하고 비교하여 활용해 보았습니다. 그렇게 진행해 보았습니다.
정확히는 Jev에 특화된 벤치마크도 있었으면 좋겠지만, 쉽지 않아 제가 수집한 숫자와 실제 측정을 비교해 보는 정도로 활용해 주세요. 측정이 불가능한 데이터도 많으니 참고용으로만 고려해 주시면 감사하겠습니다.
보고서는 가장 아래에 뭉쳐놓은 것을 넣어둡니다. 게시일도 다시 확인했으며, 업데이트가 지나치게 많습니다.
오늘, 간단히 이야기해볼게요.
최근에 읽었던 책 ‘나를 엮어준 사람들’을 읽고 깊은 감동을 받았습니다. 작가 야마모토 히로시는 자신의 삶을 솔직하고 진솔하게 풀어내며 독자들에게 큰 울림을 주었습니다. 특히 어린 시절의 기억과 가족 관계에 대한 이야기는 저에게 깊은 여운을 남겼습니다.
야마모토 히로시는 단순히 개인적인 경험을 나열하는 것이 아니라, 인간 존재의 의미와 삶의 가치에 대해 생각하게 만드는 메시지를 담고 있습니다. 그는 “우리는 끊임없이 변화하고 성장하며, 주변 사람들과의 관계 속에서 의미를 찾는다”라고 말합니다. 이러한 그의 생각은 저에게 큰 영감을 주었습니다.
이 책을 통해 저는 다시 한번 삶의 소중함을 깨닫고, 주변 사람들에게 감사하는 마음을 가지게 되었습니다. 또한 앞으로 어떻게 살아가야 할지에 대한 고민을 하게 되었습니다.
‘나를 엮어준 사람들’은 단순한 자전적 소설이 아닌, 삶의 지혜를 담은 책이라고 생각합니다. 이 책을 읽는 모든 분들에게 깊은 감동과 깨달음을 선사할 것이라고 믿습니다.
혹시 이 책에 대해 더 궁금한 점이 있으시면 언제든지 질문해주세요.
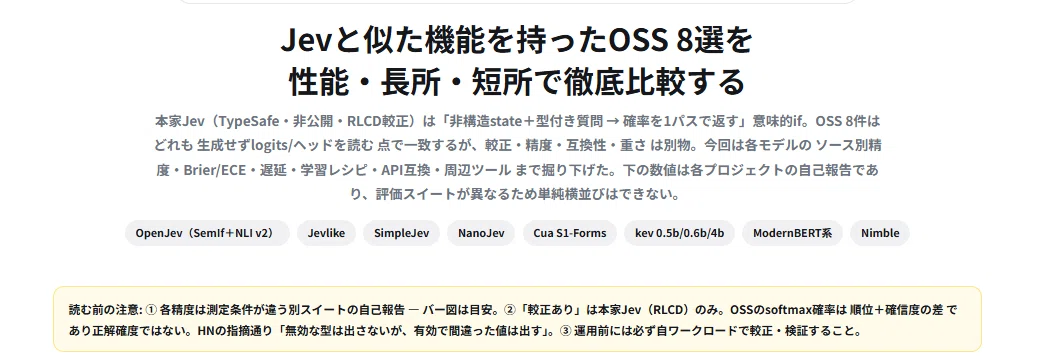
이 글에서는 초급 정보, 논문, 벤치마크를 기반으로 Jev의 작동 방식과 대표적인 오픈 소스 소프트웨어(OSS) 8개의 성능, 장점, 단점을 심층적으로 비교 및 조사해 보고자 합니다.
레이디고
1. 애초에 'Jev'란 무엇인가? 왜 초고속인가
기존 LLM(생성형)과의 결정적인 차이
기존 LLM에서 분류를 수행할 경우, 프롬프트에 대해 토큰을 순차적으로 예측(자연어 생성)하고, 문자열로 "true" 또는 `{"action": "submit"}`을 출력하도록 했습니다.
한편, Jev 및 그 재수 OSS는 텍스트 생성 루프(Decode loop)를 전혀 실행하지 않습니다.
왜 이렇게 빠르고, 쉽게 부서지지 않는 거죠?
제브(Jev)의 아키텍처(역재현 엔지니어링 논문 등으로 추정)의 핵심은 다음과 같습니다.
- 공유 상태 프리픽스(KV 캐시 공유)는 긴 문서나 상태를 한 번만 사전 계산(Prefill)하여 KV 캐시에 보관하고, 여러 질문이 동시에 동일한 캐시를 참조합니다.
- 분리된 분기(병렬 분기)에서 질문과 선택지별 처리를 블록 인과 마스크 등으로 병렬로 평가하며, 질문 간의 간섭은 발생하지 않습니다.
- 읽어내림 헤드의 마지막 숨겨진 상태에서 선택지별 로짓스를 직접 가져와 소프트맥스를 취하는 방식이다. 따라서 파싱 오류가 발생하지 않는다.
이를 통해 기존 디코더 대비 수 배에서 수십 배의 지연 시간 단축과 100% 스키마 준수를 동시에 달성한다.
## 2. Jev계 OSS 8선 스펙·비교 목록
Jev계 OSS는 다음 8종입니다. 각 OSS의 주요 특징과 비교 정보를 확인해 보세요.
**1. Mirage OS**
* **설명:** Mirage OS는 Linux 커널을 기반으로 구축된 매우 가벼운 운영체제입니다. 특히 임베디드 시스템이나 IoT 기기에서 활용하기에 적합합니다.
* **주요 특징:**
* 매우 작은 크기(수백 MB)
* 낮은 리소스 사용량
* 빠른 부팅 속도
* Linux 커널 기반
* **사용 분야:** 임베디드 시스템, IoT 기기, 테스트 환경
**2. Void Linux**
* **설명:** Void Linux는 독립적인 Linux 배포판으로, 자체 커널과 패키지 관리 시스템을 사용합니다. 최신 기술을 빠르게 도입하는 것으로 유명합니다.
* **주요 특징:**
* 독립 운영체제(AGPL 라이선스)
* 최신 커널 및 패키지 제공
* 빠른 패키지 관리 시스템(xbps)
* **사용 분야:** 서버, 데스크톱, 개발 환경
**3. AntiX**
* **설명:** AntiX는 오래된 하드웨어에서도 잘 작동하도록 설계된 매우 가벼운 Linux 배포판입니다. Debian 기반으로 제작되었습니다.
* **주요 특징:**
* 매우 낮은 리소스 사용량
* 다양한 32비트 및 64비트 아키텍처 지원
* Debian 기반
* **사용 분야:** 구형 컴퓨터, 리눅스 입문자
**4. Devuan**
* **설명:** Devuan은 Debian 기반의 운영체제로, GNU General Public License(GPL)를 준수하며 시스템 가상화 및 컨테이너 기술을 지원합니다.
* **주요 특징:**
* GPL 라이선스 준수
* 시스템 가상화 및 컨테이너 기술 지원
* Debian 기반
* **사용 분야:** 서버, 데스크톱, 개발 환경
**5. Alpine Linux**
* **설명:** Alpine Linux는 musl libc를 사용하여 제작된 매우 작고 가벼운 Linux 배포판입니다. 컨테이너 이미지로 많이 사용됩니다.
* **주요 특징:**
* musl libc 사용
* 매우 작은 크기(수십 MB)
* 컨테이너 이미지에 적합
* **사용 분야:** 컨테이너, 클라우드, 서버
**6. OpenWrt**
* **설명:** OpenWrt는 라우터 및 네트워크 장비에 최적화된 Linux 배포판입니다. 다양한 하드웨어 플랫폼을 지원합니다.
* **주요 특징:**
* 라우터 및 네트워크 장비에 최적화
* 다양한 하드웨어 플랫폼 지원
* 웹 기반 관리 인터페이스 제공
* **사용 분야:** 라우터, 공유기, 네트워크 장비
**7. Gentoo Linux**
* **설명:** Gentoo Linux는 소스 코드 기반의 배포판으로, 시스템을 사용자 정의하여 최적화할 수 있습니다.
* **주요 특징:**
* 소스 코드 기반
* 사용자 정의 가능
* 컴파일에 시간 소요
* **사용 분야:** 고급 사용자, 개발자
**8. Slackware Linux**
* **설명:** Slackware Linux는 오랜 역사를 가진 단순하고 안정적인 Linux 배포판입니다.
* **주요 특징:**
* 단순하고 안정적인 운영체제
* 오랜 역사
* 사용자 정의 가능
* **사용 분야:** 서버, 데스크톱, 개발 환경
현재 공개되어 있는 주요 OSS는 크게 3가지 시스템으로 나뉩니다.
① 기존 모델의 로짓 직접 읽어내림 방식, ② 분류 헤드를 사후 학습 방식으로 학습시킨 형태, ③ 초소형·특화 모델
일단, 이미지 첨부했고요. 혹시 복사해서 사용하실 분들을 위해 텍스트도 함께 넣어둡니다.
텍스트는 오히려 사람들이 보는 부분은 아니라고 생각합니다.
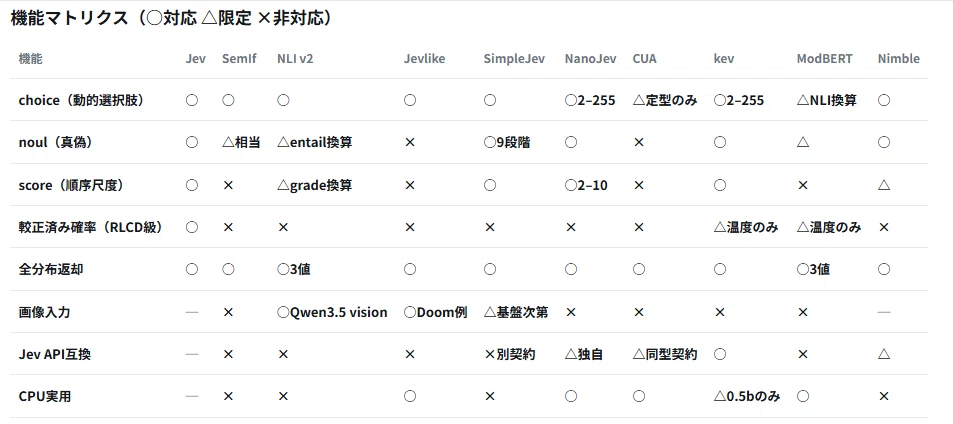
프로젝트 | 베이스 모델·방식 | 특징 / 대표 정확도(※조건부) | 지연 시간 기준 | API 호환 | 적합한 환경 본가 Jev(TypeSafe) | 희소 MoE 추정 RLCD 보정 | 개발 정확도: 0.845, OOD 정확도: 0.855 | 70~500ms(API 경유) | 본가 | 클라우드 API OpenJev SemIf(TheoLeeCJ) | Qwen3.5-4B 동결 Direct Logits | 자체 제작 144건: 0.813, WANLI: 0.637 | 21회 판정으로 1.02s(RTX 3090) | CLI / WebGPU | 개발·검증(학습 불필요) Openjev NLI v2(AlexWortega) | Qwen3.5-4BNLI Cross-Encoder | MNLI: 0.904, Doom: 11.0 kills | 57ms/판정(이미지: 101ms) | 독자 규격 | 제로샷 판정 멀티모달 Jevlike(vinnylarouge) | byte 임베딩 / 동결Enc+ Scorer 학습 | 합성: 98%, Wiki: 26~29% | Decoder 대비 약 100배 고속 | 라이브러리 | CPU 운용 알고리즘 학습 SimpleJev(featherless-ai) | HuggingFace 호환 Logits 읽기 | 베이스 모델 의존(RFDT 훈련) | 모델 의존 | /v1/classifier | 기존 HF 모델의 API 서버화 NanoJev(TianyuCodings) | Qwen3-0.6B+ Decision Heads | 헤맴 경로: 95% 정확도: 90% | 여러 질문을 1번 포워드로 일괄 검사 | 자체 거주 데몬 | 에지-경량 Bot 게임 AICua S1-Forms(cua-ai) | 706k 파라미터 특화형 (Jevlike 파생) | 자체 폼: 99.7% (조건부) | 7~9ms (로컬 실행) | 드라이버 통합 | 정형 업무 폼 CPU 및 임베디드 Kev (0.5b/0.6b/4b)(jaredpalmer) | Qwen + LoRA r16+ Pointer Head | 4b 개발: 0.8434b 정확도: 0.759 | 패키지 배치로 2배 속도 향상 | 본가 API 완전 호환 | 본가 Jev의 대체 자체 호스팅 ModernBERT 기반 (ModernCE 등) | ModernBERT-large (395M) NLI | MNLI: 0.909, SNLI: 0.9
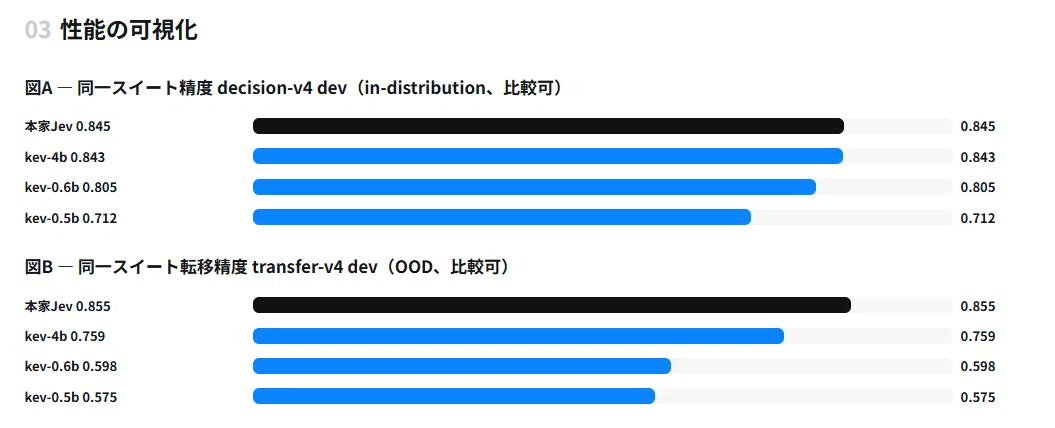
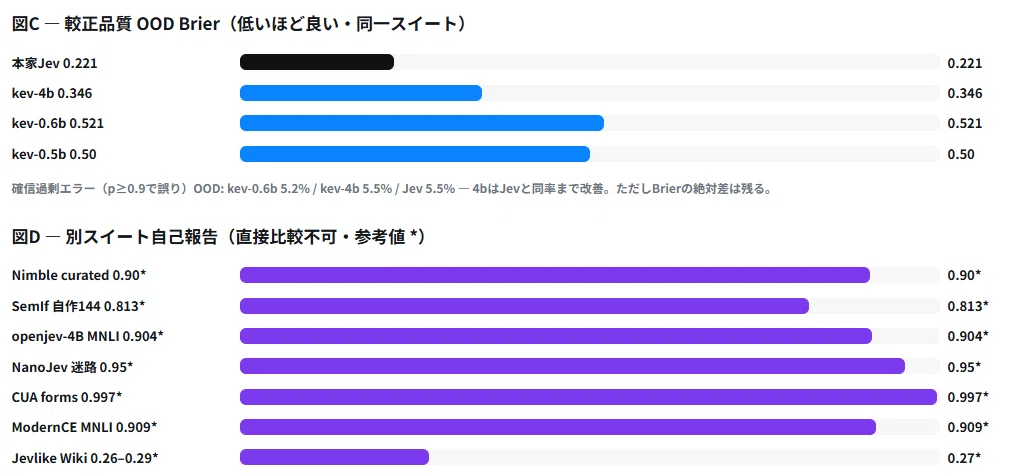
참고: Nimble (Bespoke/9B) 등도 공개되었지만, 제가 직접 사용해보지는 못했습니다. 위에 언급된 8가지 모델이 현재 실용성과 검증 측면에서 가장 많이 논의되는 대표적인 모델입니다. 각 정확도 수치는 평가 스위트가 다르기 때문에, 단순 비교에는 주의가 필요합니다.
각 오픈 소스 프로젝트의 개별 평가: 장점과 단점
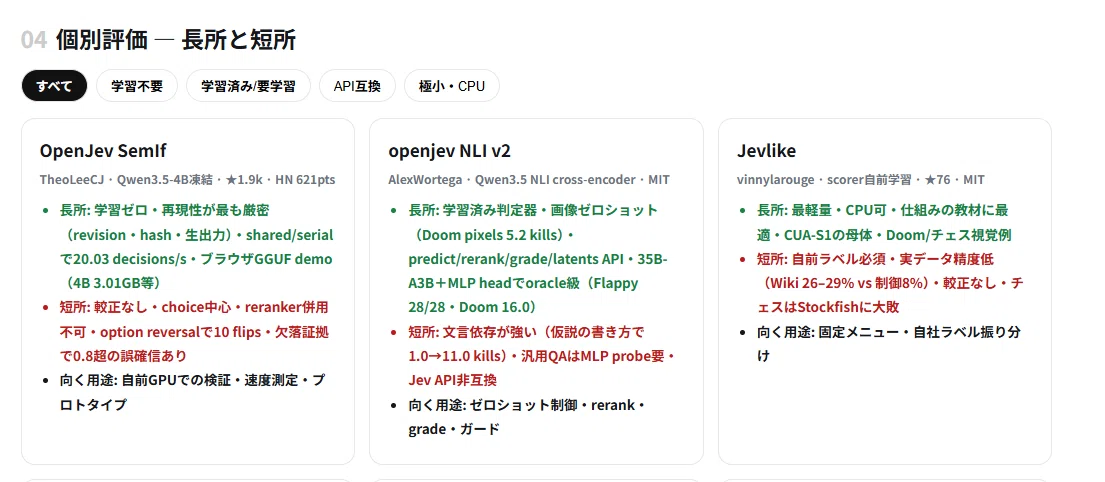
OpenJev (SemIf) — 배우기 전혀 필요 없이 지금 바로 시도해 볼 수 있는 대표적인 예시
- 장점: 추가 학습이 전혀 불필요하며, Qwen3.5-4B의 베이스 Logits를 그대로 읽어내어 스크립트 하나로 즉시 실행됩니다. WebGPU 또는 MLX를 이용한 Mac 로컬 환경에서도 작동합니다.
- 단점: 교정(캘리브레이션)이 이루어지지 않았기 때문에 선택지 순서를 변경하면 판정 결과가 반전되는 “옵션 역전”이 발생하기 쉽다.
- 추천: “먼저 현장 GPU에서 Jev적인 아키텍처의 속도감을 직접 느껴보고 싶을 때.”
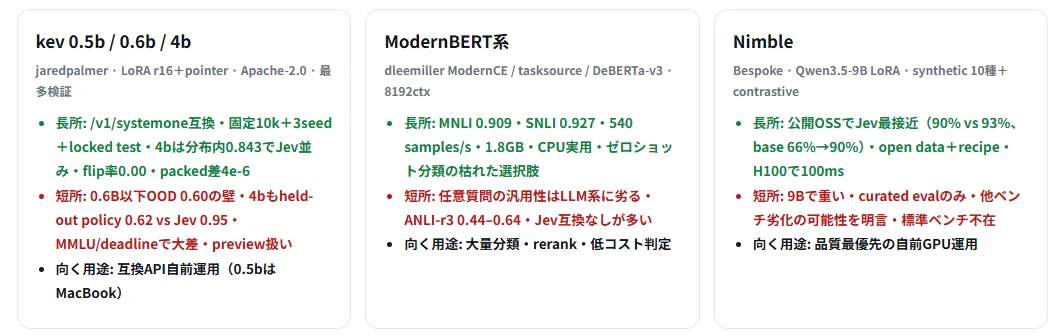
② kev (0.5b / 0.6b / 4b) — Jev API 완벽 호환 및 가장 신뢰성 있는 검증
- 장점: 본가 Jev의 `/v1/systemone`과 동일한 인터페이스를 제공합니다. 고정된 1만 건의 멀티 시드 테스트를 실시한 결과, 4b 모델의 분포 내 정확도는 0.843으로 본가 Jev(0.845)에 근접하며, 선택지 재배열을 통한 플립률 또한 0.00%로 매우 견고합니다.
- 단점: 0.6b 이하의 소형 모델은 미확인 데이터(OOD)에서 정확도 60% 전후의 한계에 부딪힌다. 또한, 날짜 계산과 같은 합성 추론에서는 본래의 것에 미치지 못한다.
- 추천: “본래 Jev의 API 사양 그대로 내부 GPU 서버로 전환하고 싶을 때.”
오픈제브(OpenJV) NLI v2 — 이미지 입력 및 제로샷 제어에 강점을 지닌다.
- 장점: 자연어 추론(NLI) 기반으로 튜닝되어 있으며, 이미지 입력(둠 게임 화면 등)을 통해 직접 행동을 결정할 수 있습니다.
- 단점: 프롬프트(가설문)의 표현 방식에 정밀도가 크게 의존하며, 가설의 작성 방식에 따라 게임 점수가 10배 이상 변동될 수 있다.
- 추천: 에이전트의 안전장치, 리랭킹, 이미지 포함 멀티모달 판정.
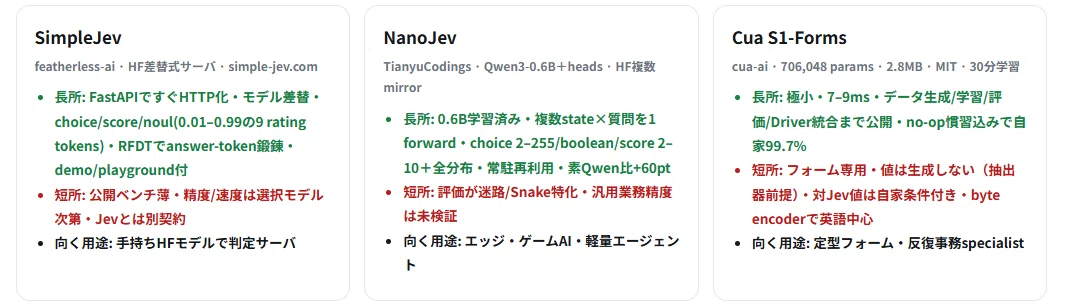
④ Cua S1-Forms — 무려 2.8MB 크기, 7ms 응답 속도를 자랑하는 특화 모델
- 장점: 파라미터 수는 70만 개(약 2.8MB)로 매우 적습니다. CPU 환경에서 7~9ms의 초고속으로 작동하며, 웹 폼 입력 보조 및 건너뛰기 판별에 특화되어 있습니다.
- 단점: 양식 입력 전용으로, 새로운 개념이나 자유롭게 작성한 내용의 이해는 불가능하며 활용성이 전혀 없습니다.
- 추천: RPA와 정형 브라우저 작업을 밀리초 단위로 처리하고 싶을 때.
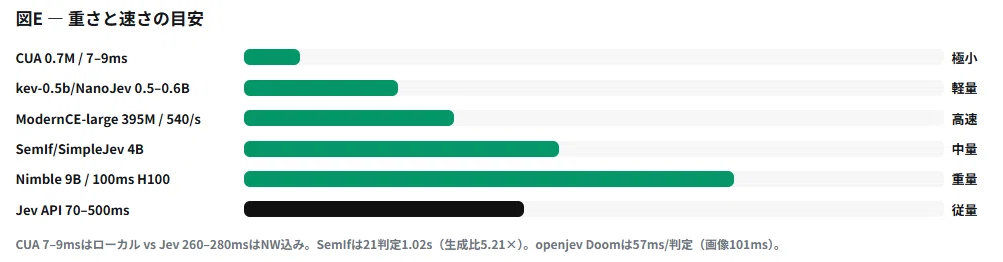
⑤ ModernBERT 기반 (ModernCE) — 최적의 비용 대비 성능을 제공하는 숙성된 기술
- 장점: 395M 클래스 인코더 모델로, 초당 540 샘플을 처리 가능하며 VRAM 용량 또한 2GB 미만입니다.
- 단점: 생성 모델 기반의 유연한 문맥 이해 및 복잡한 추론은 어려움.
- 추천: 대량의 텍스트 분류 및 콘텐츠 모더레이션을 CPU 또는 저렴한 GPU로 처리하고자 할 때.
4. 운용 전에 알아야 할 “확률”의 함정
투자 전략을 검토할 때, 확률이라는 말이 빈번하게 사용됩니다. 하지만 확률을 잘못 해석하면 투자 판단을 흐리는 주요 원인이 됩니다. 여기서는 투자자가 운용 전에 알아야 할 “확률”의 함정에 대해 설명합니다.
확률을 이해하는 데 중요한 것은 확률이 미래를 예측하는 것이 아니라, 단순히 과거 데이터를 기반으로 산출되는 통계적 경향을 나타내는 것임을 이해해야 한다는 것입니다. 즉, 과거 데이터가 미래에도 똑같이 반복될 것이라고 단정할 수 없는 것입니다.
예를 들어, 어떤 주식이 과거 10년간 연평균 5%의 수익을 올렸다는 데이터가 있다고 가정해 봅시다. 이 데이터로부터 “이 주식은 앞으로도 연간 5%의 수익을 계속 올릴 것이다”라고 결론짓는 것은 위험합니다. 왜냐하면 경제 상황, 산업 동향, 기업 실적 등 다양한 요인이 변화하여 과거와 다른 결과가 나타날 수 있기 때문입니다.
또한, 확률을 과도하게 믿으면 손실을 회피하기 위한 대책을 소홀히 할 수 있습니다. 예를 들어 “확률적으로 이 투자는 성공할 것이다”라고 생각만 하고 위험 관리를 소홀히 하면 큰 손실을 볼 수 있습니다.
투자는 확률을 참고하면서도 항상 상황을 분석하고 유연하게 대처하는 것이 중요합니다. 확률만 맹신하는 것이 아니라 투자 대상의 특성, 시장 환경, 자신의 투자 목표 등을 종합적으로 고려하여 신중하게 판단해야 합니다.
더욱이 확률 계산 방법에도 주의해야 합니다. 단순한 평균값뿐만 아니라 표준편차나 분산과 같은 통계적 지표를 활용하면 보다 정확한 확률을 파악할 수 있습니다.
마지막으로 확률을 이해하는 데 가장 중요한 것은 투자는 항상 불확실성을 수반한다는 점을 인식해야 한다는 것입니다. 확률을 완전히 통제할 수는 없지만 확률을 이해하고 위험을 관리함으로써 투자 성공의 가능성을 높일 수 있습니다.
여기 현장 도입에서 가장 중요한 점입니다.
해커 뉴스 등 커뮤니티에서도 강력하게 지적되고 있지만, 오픈 소스 버전의 Jev 클론은 “유효한 출력을 하지 않으면서도 ‘타입 에러’는 발생하지 않는 경향이 있다”는 문제점을 보인다.
환청이 아니지만, 잘못된 선택을 하는 것입니다. 정말 중요한 일입니다.
하지만 인간마저도 ‘모든 것을 완벽하게 정확한 선택’을 알 수 없는 한, 이곳을 100%로 완벽하게 만들 수 없다. 과연 현재 잘못되고 있다고 여겨지는 선택이 정말로 잘못된 것인지, 그 문제에 대한 이야기라는 모양이다.
사람의 시각에서 보기에 옳은 선택일까. 음, 어렵네.
물론, 정해진 형식의 사무 작업이라도 오선택이 발생하고, 정답을 선택하는 것조차 지속하기 어려운 경우가 있습니다. 이는 분명한 사실입니다.
중요한 것은 “어떤 이유에서든 실수는 발생한다는 사실”입니다.
Softmax 확률은 “정답의 확실성이 아니다.”
OSS 모델이 출력하는 확률은 단순히 “주어진 선택지 중에서 상대적으로 높은 것이 哪個였는가”를 나타내는 Softmax 값에 지나지 않습니다.
본가 Jev는 강화 학습에서 AI/헌법적 피드백을 기반으로 한 의사 결정(RLCD, Reinforcement Learning from AI/Constitutional Feedback on Decision) 등 비공개 기법으로 “확률이 0.8이라면, 정말 80%의 확률로 정답을 맞히는” 것처럼 교정(캘리브레이션)되었습니다.
하지만 대부분의 오픈 소스 소프트웨어는 학습 과정에서 이러한 보정이 이루어지지 않아 “거짓말 같지만 확률 0.99”를 당혹감 없이 출력(확신 과잉)하는 경우가 많습니다.
실제 적용을 위한 3가지 핵심 원칙
- 선택지 안에 반드시 “該当 없음 / 정보 부족”을 포함하는 맥락에 답이 없는 경우, 모델은 어쩔 수 없이 특정 선택지에 높은 확률을 할당해 버립니다.
- 온도 스케일링을 수행한 자체 테스트 데이터로 출력 온도 T를 조정하여 Brier 점수와 ECE(예상 캘리브레이션 오류)를 최소화한다.
- 혼란 테스트(Permutation Test)를 실시하는 선택지 순서(A/B/C → C/B/A)를 바꾸어도 동일한 결과와 확률이 유지되는지 반드시 검증한다.
5. 목적별로 무엇을 선택해야 하는가?
채용 기준을 다이어그램 형식으로 정리했습니다.
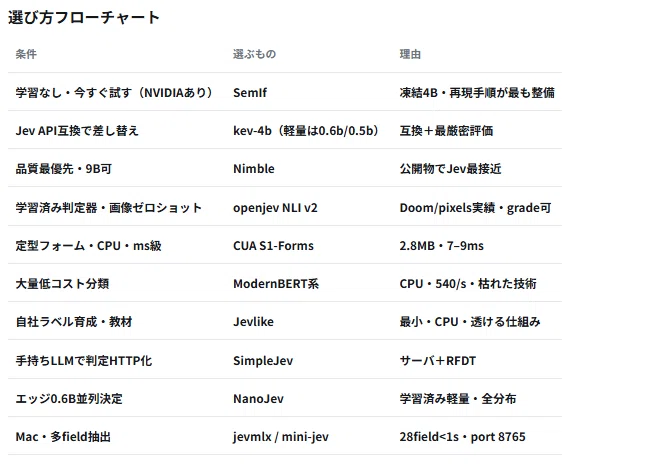
저의 PC에서 직접 측정한 숫자들도 보고서에 정리하고 있습니다.
미니 PC라서 솔직히 얼마나 도움이 될지는 모르겠지만, 일단 덮어두고 보려고 생각 중입니다. 필요 없으면 그냥 넘어가 주세요. 아래는 일부입니다. nimble의 경우, 최초 정보에서 발췌한 내용입니다.
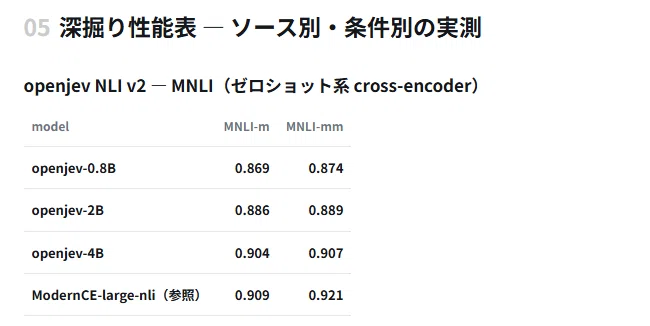
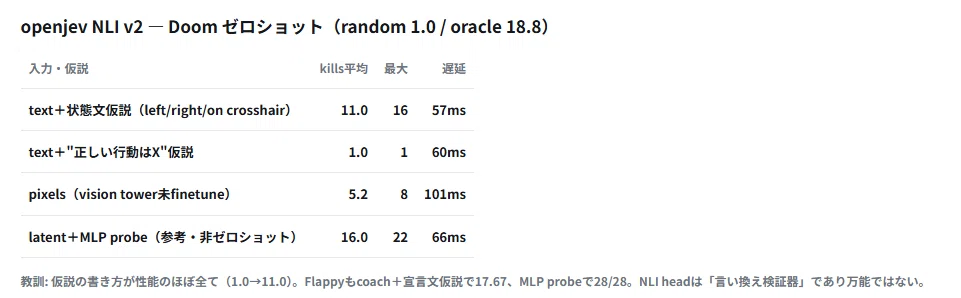
주변 생태계와 시계열 분석
이미지를 첨부하여 보여드리겠습니다. 대략 이런 느낌입니다.
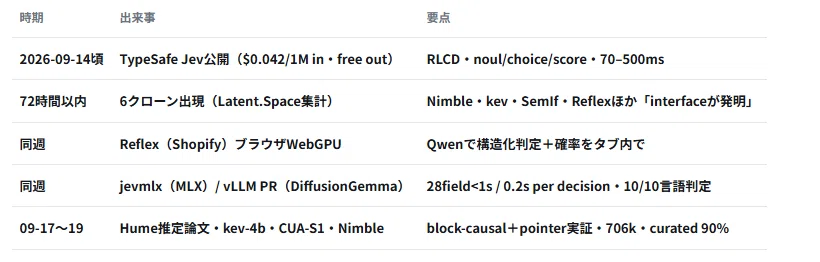
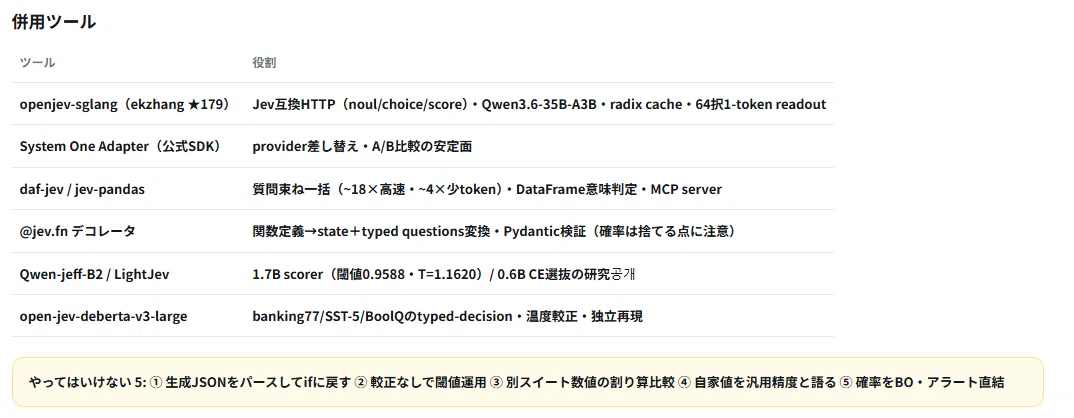
결론: 모델은 “생성 시기”에서 “단일 경로 분기 시기”로 전환되고 있다.
음, 정말 재미있게 사용해 보았어요.
제브가 제시한 본질적인 가치는 모델을 추론 엔진이 아닌 안전하고 빠른 라우팅 장치(의미론적 if 문)로 재정의한 데서 비롯되었다.
- 모든 처리를 무거운 디코딩 루프로 돌릴 필요는 없습니다.
- 문서 라우팅, 가드레일, 폼 입력 판별 등의 사전 계산 KV 캐시와 1패스 판정으로 충분하며, 그 방식이 압도적으로 견고합니다.
어떤 것을 도입할 때는, 먼저 학습이 필요 없는 SemIf나 API 호환형 kev로 프로토타입을 만들고, 반드시 자체 데이터로의 교정(캘리브레이션)을 거친 후, 신뢰성 높은 워크플로우를 구축해 보시기를 권장합니다.
좋게 부탁드립니다, 스키, 기다리고 있어요.
출처 및 라이선스 참고
TypeSafe 공식 출시·Apidog 대체품 총정리·TheoLeeCJ/SemIf(RESULTS/METHOD/REPRODUCE 09-18판)·AlexWortega/openjev 모델 카드+커밋 기록(MNLI/Doom/Flappy/MLP 표)·vinnylarouge/jevlike·featherless-ai/simple-jev DeepWiki·TianyuCodings/NanoJev+aaroncool9 미러·rongxinzy/LightJev·cua-ai/cua-s1-forms+RuntimeWire/HN·jaredpalmer/kev-0.5b/0.6b/4b 카드(decision-v4/transfer-v4·Brier·시드·잠금 테스트)·Archer Hume “Jev's Architecture Unmasked”·Latent.Space 6개 클론·Bespoke Nimble 발표·dleemiller ModernCE-large/base+tasksource·mini-jev(CLINC150·사전 등록)·bnsd55/jevmlx·Shopify Reflex·vLLM PR #57250·Viswa Kumar RLCD 해설·ConfidenceBench/Calibration 논문.
무게와 데이터는 각 라이선스(MIT/Apache-2.0/Qwen/CC-BY 등)를 준수하며, 수치는 2026년 9월 18일 기준 보고를 반영합니다.
다음은 보고서입니다.
출처: note 원문
번역: Gemma 3(.44) 초벌 + 교정 68청크
원문 보기 | 출처: note.com