
가성비를 중시한다면 Sonnet, 품질을 중시한다면 Opus.
얼마 전 기업 대상 AI 세미나의 질의응답에서 Claude의 용도별 사용 구분에 대한 질문을 받았을 때 그렇게 답했습니다.
오늘 그 답을 다시 씁니다.
일본 시간으로 9월 23일에 “Claude Opus 5.5”, 그로부터 불과 6일 뒤인 9월 29일에 “Claude Sonnet 5.5”가 발표되었습니다.
뉴스에는 “Sonnet이 Opus를 넘어섰다”라는 헤드라인이 넘쳐나고 있습니다.
그렇다면, Claude Pro를 사용하고 있는 우리는 내일부터 무엇을 선택해야 할까요?
그래서 이번 글은 Claude Pro(월 20달러)를 사용하다 주 도중에 한도에 도달해 일이 멈추는 분, 그리고 새 모델이 나올 때마다 ‘어떤 것을 선택해야 할지’ 망설이는 분들을 위해 쓰고 있습니다.
먼저 결론부터 말씀드립니다.
- 평소에는 Sonnet 5.5.
- Opus 5.5는 "생각하는 일"에만.
- 그리고 Claude 밖에서 끝낼 수 있는 일은 Claude에 넣지 않는다.
AI를 실무에서 3년 반 이상 계속 사용해 오면서 실제로 운용하고 있는 역할 분담 방식을, 제 업무의 실제 사례 3가지와 함께 소개합니다.
🆕 Sonnet 5.5는 '저렴한 Opus'가 아니다
먼저, 확인된 사실만을 짚어보겠습니다.
Anthropic의 발표에 따르면, Sonnet 5.5는 이전 Sonnet 5와 비교해 출력이 30% 이상 빨라졌습니다.
요금 단가는 그대로 유지됩니다. 그럼에도 같은 작업을 마치는 데 필요한 토큰(AI가 읽고 쓰는 문자량의 단위)이 줄어들기 때문에, 작업 1건당 최대 30% 저렴해진다고 설명되고 있습니다.
잘하는 것은 범위가 정해진 일상 업무, 버그 수정, 문서·슬라이드·스프레드시트 마무리입니다.
한편, Anthropic 스스로도 “복잡하고 정답이 정해져 있지 않으며 판단이 장기간 이어지는 작업에서는 Opus 5.5가 명확히 더 강하다”고 언급하고 있습니다.
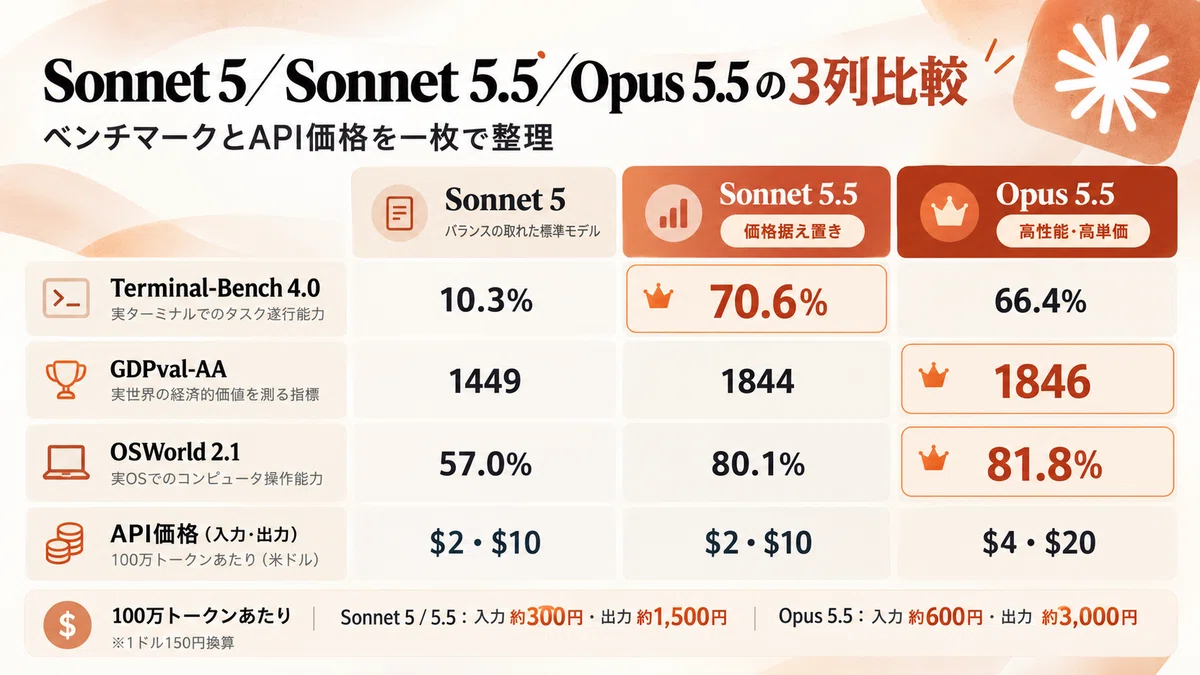
여기에 한 가지 주의할 점이 있습니다. 화제의 “Terminal-Bench에서 Opus 추월”은 Sonnet을 “최대 에포트”로 실행했을 때의 수치입니다. 동일한 조건으로 비교하면 Opus가 앞서는 항목도 남아 있습니다.
제목만 보고 전부 갈아타면 오히려 손해를 봅니다.
이제는 '가성비냐, 품질이냐'의 양자택일이 아닙니다. 품질 수준이 거의 같은 두 모델을 업무 성격에 따라 골라 쓰는 시대가 되었다고 저는 생각합니다.
🎚️ 설정은 단 2가지: Sonnet 5.5 × 에포트 ‘중간’
Claude 화면에서는 모델과 함께 '에포트'를 선택할 수 있습니다.
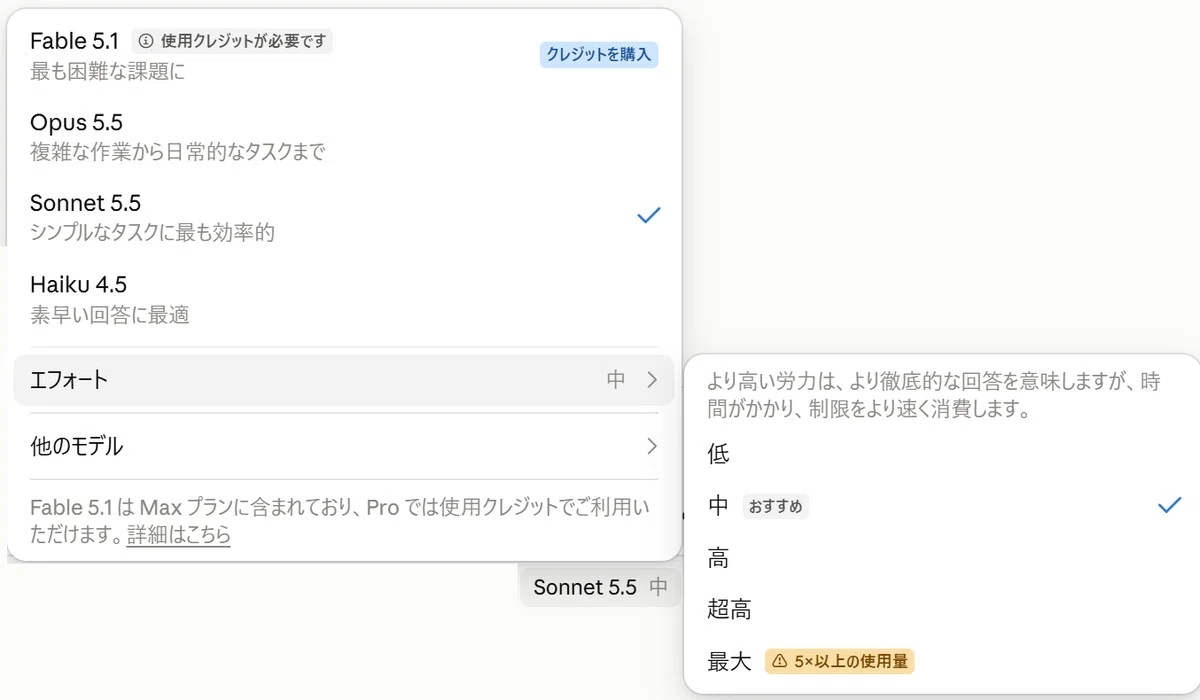
에포트는 AI에게 어디까지 시간을 들이고, 어디까지 스스로 판단하며 진행해도 되는지를 정하는 다이얼과 같은 것입니다.
머리가 좋은 것 자체를 전환하는 스위치는 아닙니다.
화면을 보면, “최대”에는 “5× 이상의 사용량”이라는 경고가 붙어 있습니다. 제3자 측정 기관인 Artificial Analysis도 Sonnet 5.5를 최대 에포트로 실행하면 단일 과제에서 약 19만 토큰을 출력했다고 보고했습니다.
제 사용법은 다음 세 가지뿐입니다.
- 낮음. 다른 말로 바꾸기, 짧은 답장, 대량의 정형화된 작업.
- 중국. 거의 모든 일. 여기서 옮기지 않습니다.
- 높습니다. 원인을 알 수 없는 버그나 조건이 많은 분석을 할 때뿐입니다.
⚠️ 주의점. 프롬프트에 '잘 생각해'라고 쓰는 것보다 에포트 설정을 한 단계 올리는 편이 더 효과적입니다. 반대로, 최대 설정을 계속 사용하면 주중에 상한에 도달합니다.
🧭 3초 만에 결정하기: 답을 ‘만들’ 것인가, ‘생각할’ 것인가
모델 선택에 망설일 때는 자신에게 단 한 가지만 물어봅니다.
출처: note 원문
번역: Gemma 3(.44) 초벌 + 교정 22청크
원문 보기 | 출처: note.com