
Claude Code의 effort(얼마나 깊이 생각하게 할지를 정하는 조절 장치)는 2026년 9월 기준으로 Opus 5.5·Sonnet 5.5 모두 기본값이 medium입니다. Anthropic 재직자들은 입을 모아 “기본값 그대로가 좋다”, “Sonnet에는 max를 쓰지 않는다”고 말합니다. 정말 그런지, 동일한 청구 내역 체크(가상의 14행·오류 7건)를 Sonnet 5.5와 Opus 5.5, effort low/medium/high/max의 8가지 조합으로 실행해 본 결과, 검출 수는 8회 모두 7건 중 7건, 소요 시간은 low~high가 10~13초, max만 약 2분 24초였습니다. 비용은 Opus가 Sonnet의 약 2배, max는 medium의 2.6~3.2배입니다. 이 글에서는 재직자 5명의 발언을 날짜와 함께 나열하고, effort를 올리면 고쳐지는 실패와 고쳐지지 않는 실패를 Anthropic이 공개한 실제 수치로 확인한 뒤, 전문직·백오피스 업무에 어떻게 적용할지를 판단의 틀로 정리합니다. 검증 환경: Claude Code v2.1.284, claude-sonnet-5-5/claude-opus-5-5, 2026년 9월 29일 실시. 숫자는 모두 말미의 출처나 직접 측정한 로그에 근거합니다.
왜 지금 노력에 대한 이야기인가
이유는 9월 28일에 출시된 Sonnet 5.5에서 Claude Code의 '기본값'이 바뀌어 올려야 할지 고민하는 사람이 늘어났기 때문입니다. Anthropic은 9월 23일에 Opus 5.5와 함께 effort의 기본값을 medium으로 정했고(Opus 5의 기본값은 high), Sonnet 5.5도 Claude Code에서는 medium이 기본값입니다. "올리면 더 똑똑해지는데 왜 기본값은 낮췄는가"라는 의문에 Claude Code 팀 엔지니어 Thariq Shihipar씨가 9월 25일 공식 블로그에서 답했으며, 해당 공지 포스트는 노출 140만·북마크 1만 건(2026년 9월 29일 기준)을 기록했습니다.
에포트란 실제로 무엇일까? 언제 에포트를 변경해야 하며, 왜 모든 것에 그냥 최대 에포트를 사용하지 않는 걸까? 나는 이 문제를 깊이 파고들며 평가를 살펴보고 직접 테스트를 해봤는데, 결과에 꽤 놀랐다. https://t.co/KO2D51j34H — Thariq (@trq212) September 25, 2026
일본어권에는 'effort란 무엇인가'에 대한 해설은 많지만, 재직자의 발언을 모아 업무 데이터로 확인한 기사는 당 연구소에서 확인한 바로는 찾아볼 수 없었습니다(2026년 9월 29일 기준).
Anthropic 내부 사람들은 노력을 어떻게 활용하고 있을까?
결론은 “기본값인 medium으로 시작하고, high는 검증이 필요한 경우에만, max는 일상적으로 사용하지 않는다. Sonnet이라면 max는 사용하지 않는다”는 점에 5명이 일치했습니다. 시간 순서대로 나열합니다.
9월 23일: Cat Wu씨(Claude Code 프로덕트)——medium을 전 제품의 기본값으로
Cat Wu씨는 Opus 5.5를 Claude Code와 Claude 앱의 기본 모델로 지정함과 동시에 effort medium을 모든 제품의 기본값으로 설정한다고 발표했습니다. 그 이유로 medium으로도 충분한 지능을 더 빠르게 제공할 수 있다는 점과 Opus 5 대비 이용 한도가 25% 더 오래 지속된다는 점을 들었습니다.
Claude Opus 5.5는 이제 Pro, Max, Team 플랜에서 Claude Code와 Cowork를 포함한 Claude 앱의 기본 모델이 되었습니다. 저는 Opus 5.5를 매일 쓰는 주력 모델로 사용하고 있는데, 명확한 소통 능력과 제 문체에 맞춰 글을 써주는 점이 마음에 듭니다. 기본 노력 수준은 medium으로 설정합니다… https://t.co/iSFyRr4RZd — cat (@_catwu) 2026년 9월 22일
9월 23일: Lydia Hallie씨(Anthropic)——일상적인 작업의 대부분은 중간 수준이며, 여러 파일에 걸친 변경만 높은 수준이다
공식 YouTube 해설 영상에서 Lydia Hallie씨는 이렇게 말합니다.
"Opus 5.5 also defaults to medium effort, and effort is basically how much thinking it puts into a turn before it acts. So everything you just saw was on medium effort, and for most of what I do on a daily basis that's enough, but there are some cases where I still go to high."(Opus 5.5의 기본값도 medium입니다. effort란 행동하기 전 한 턴에 얼마나 사고하는지를 의미합니다. 지금까지 보신 것은 모두 medium이었고, 제가 평소 하는 일의 대부분은 그것으로 충분하지만, high로 올리는 경우도 있습니다)—Lydia Hallie씨(Anthropic), YouTube "Using Claude Opus 5.5 as your daily driver" 2026년 9월 23일
영상에서는 medium으로 요청한 항목명 변경이 다른 파일을 빠뜨려 ‘틀리지는 않았지만 불완전’하게 되고, high로 전환하자 모든 부분을 고친 사례가 소개됩니다. “여러 파일에 걸친 변경만 high로 하고, 끝나면 medium으로 되돌린다”가 그의 운용 방식입니다.
9월 25일: Thariq Shihipar씨(Claude Code 엔지니어)——low로 만들고, high로 검증한다
Thariq 씨의 공식 블로그는 노력의 정의를 이렇게 쓰고 있습니다.
“effort는 모델에게 해당 작업에 투입하기를 원하는 연산량의 대략적인 기준을 알려준다. Claude는 언제나 작업을 합리적으로 수행하려 하지만, effort가 높을수록 판단과 검증을 위해 보다 독자적으로 움직인다”(effort는 그 작업에 얼마나 많은 연산을 써주길 바라는지의 기준을 모델에게 주는 것이다. Claude는 어떤 effort에서도 작업을 적절히 처리하려 하지만, effort가 높을수록 판단과 검증을 위해 스스로 움직이는 양이 늘어난다) — Anthropic Claude Code팀 Thariq Shihipar, claude.dev “Using Claude Code: Spending your effort”, 2026년 9월 25일
본인이 운용하는 순서는 “사양을 전달하고 부족한 점은 인터뷰로 확인하게 한다 → low로 구현한다 → 요점이 맞는지 확인하면서 low로 반복한다 → high로 검증·테스트한다”이다. 기준은 low=브레인스토밍이나 초안, medium=일반적인 기능 구현, high=검증이 중요하고 엣지 케이스가 있는 작업, max=난제를 완전히 자율적으로 풀게 할 때이다.
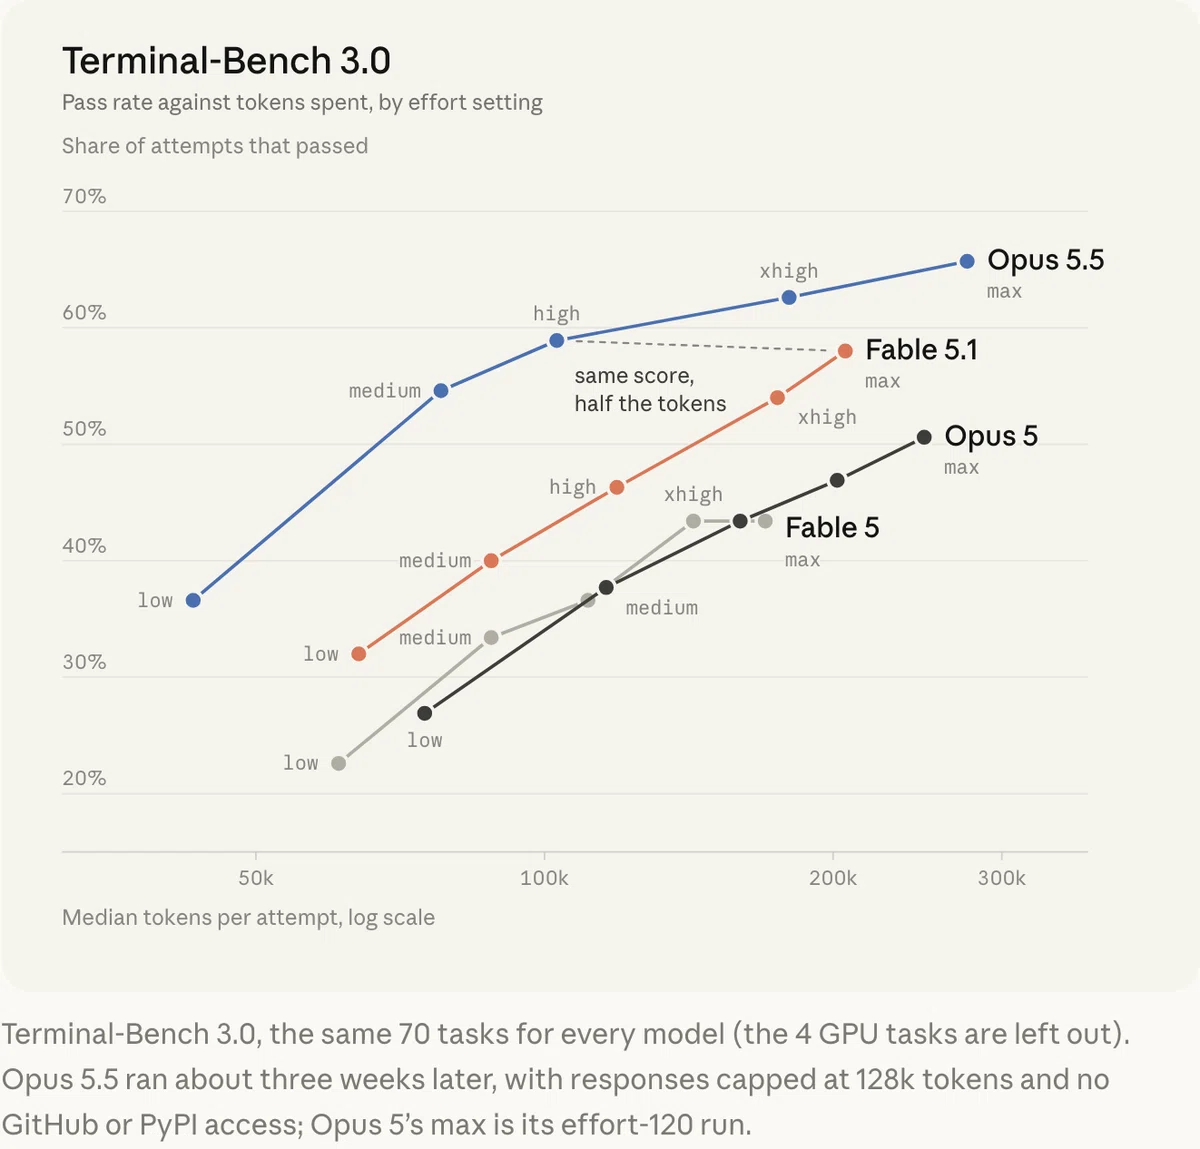
위 그림은 Terminal-Bench 3.0(70개 과제)의 합격률을 1회 시도당 토큰 중앙값에 대해 나타낸 것입니다. Opus 5.5는 medium에서 약 54%, high에서 약 58%, max에서 약 65%(육안 추정치)로 오른쪽으로 갈수록 개선 폭이 둔화되고, 토큰은 수 배로 늘어납니다. 주석과 같이 Opus 5.5의 high는 전 세대 Fable 5.1의 max와 “같은 점수를 절반의 토큰으로” 달성하고 있습니다. 기본값이 medium으로 낮아진 배경에는 바로 이 곡선이 있습니다.
9월 28일: Anthropic의 Addy Osmani——xhigh・max는 “평가에서 효과가 입증된 경우에만”
공식 가이드 “Building with Claude Sonnet 5.5”는 Claude Code의 기본 effort는 medium, API의 기본값은 high라고 명시하고, xhigh와 max는 “평가에서 품질 향상이 입증된 경우에 한한다”고 밝히고 있다. 범위가 명확한 일상 업무(코딩, 버그 수정, 대량 처리, 문서 및 슬라이드 작성)는 Sonnet 5.5, 신중한 판단이 필요한 장시간 작업은 Opus 5.5로 구분하며, 원문은 “가장 어렵고 장기적인 작업에는 Opus 모델이 더 나은 선택이다”이다.
9월 29일: edwin씨(Anthropic)——Sonnet에 max를 사용하지 않는다
Sonnet 5.5 공개 직후, edwin씨는 이렇게 올렸습니다.
“Sonnet을 max effort로 사용하지 마세요! 그 정도까지 필요하다면 아마 Opus를 사용해야 합니다… 대부분의 분들께 드리는 저희 권장 사항은 ‘그 다이얼은 건드리지 마세요’입니다” — edwin씨(Anthropic), X 2026년 9월 29일
솔직히 직설적으로 말하겠습니다. Sonnet을 max effort로 사용하지 마세요! 그럴 거면 차라리 Opus를 쓰는 게 낫습니다. Sonnet은 품질·속도·비용의 균형을 맞춘 모델이니까요. 최대로 밀어붙이면 훨씬 더 오래 생각하고... 시간도 더 걸리고... 비용도 더 듭니다. 그 이점이 사라지기 시작합니다... — edwin (@edwinarbus) 2026년 9월 28일
외부 실무자들도 같은 방향입니다. Every의 Kieran Klaassen 씨는 같은 날 “반복이 빠른 작업은 Sonnet 5.5의 로우/미디엄으로, 하이 이상이나 장시간 작업은 Opus로”라고 밝혔습니다(조회 수 13.4만, 2026년 9월 29일 시점).
왜 굳이 Sonnet 모델을 쓸까? 물론 3.5는 좋았지만, 그 이후로는 거의 써본 적이 없다. 그러다 Sonnet 5.5가 나왔는데, 꽤 마음에 든다. 이유는 이렇다. Opus 5.5의 연장선 같은 느낌으로, 전부는 아니지만 많은 면에서 품질이 비슷하면서도 훨씬 저렴하고 빠르다. 그리 대단하지는 않… https://t.co/4HRq6EMAw1 — Kieran Klaassen (@kieranklaassen) September 28, 2026
노력을 기울이면 고쳐지는 실패, 고쳐지지 않는 실패란?
노력이 줄이는 것은 '누락'이고, '판단 오류'는 거의 줄어들지 않습니다. Thariq씨는 Terminal-Bench 3.0의 실패를 유형별로 집계했습니다(Fable 5.1, 370회 시도).
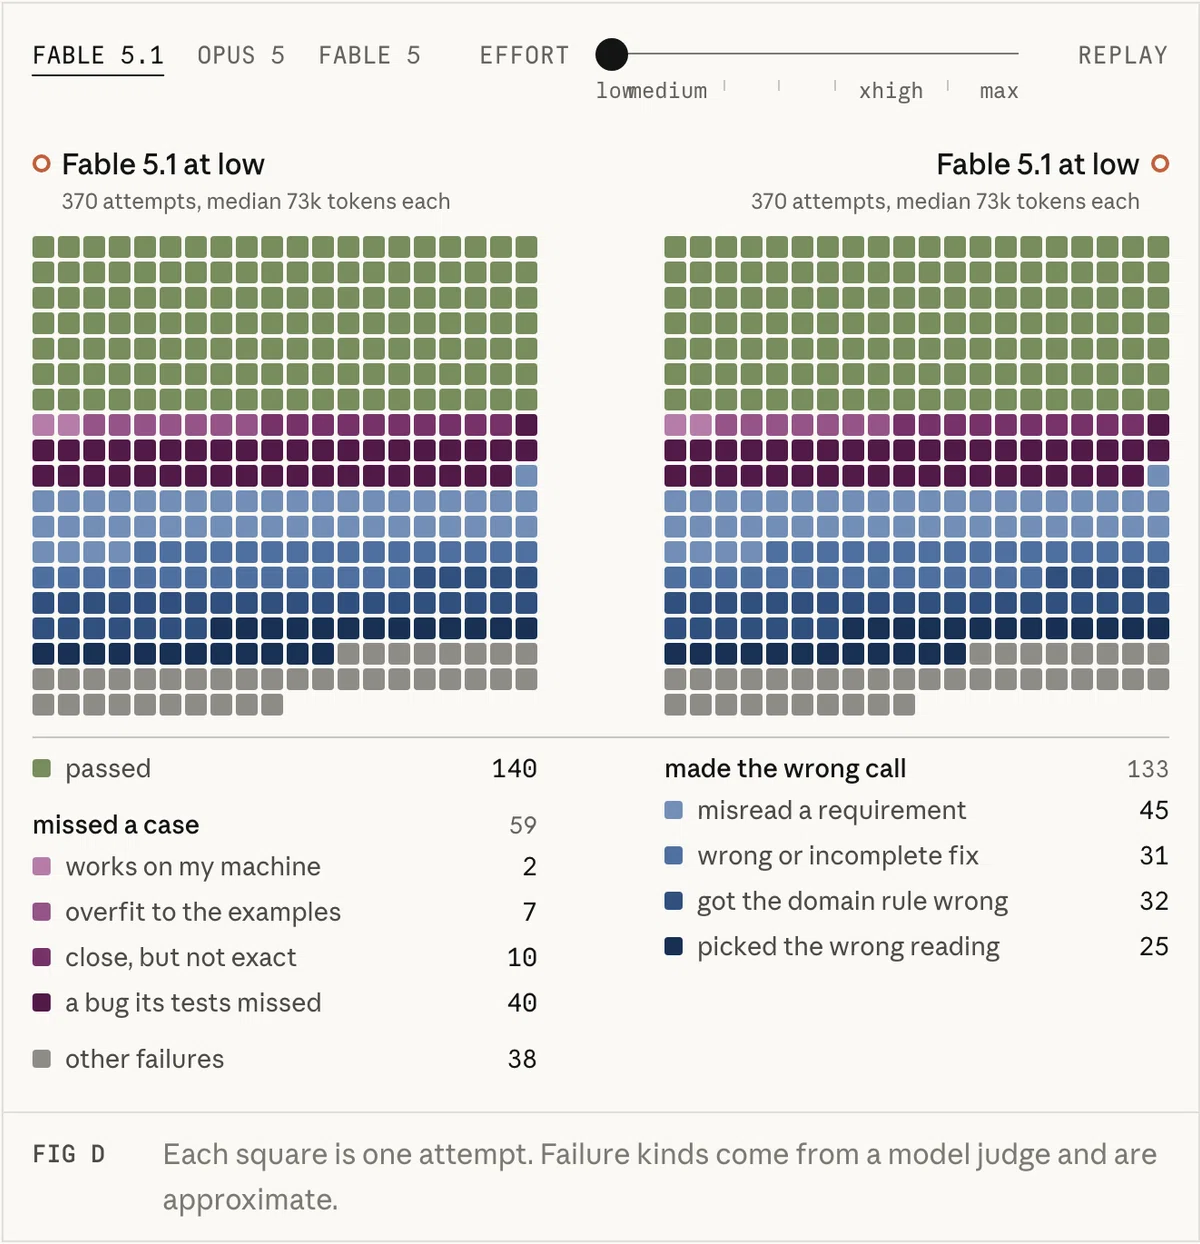
그림은 low 상태 기준입니다. 공개된 수치에 따르면, low에서 max로 올리면 합격은 140→214로 늘고, ‘놓침(missed a case)’은 59→24로, ‘자체 테스트로 잡아내지 못한 버그’는 40→14로 크게 줄어듭니다. 반면 ‘판단 오류(made the wrong call)’는 133→107로 감소하는 데 그칩니다. 저자는 “increasing effort tends to reduce failures due to missing edgecases, but does not fix when the model has the wrong approach.”(effort를 높이면 엣지 케이스 누락으로 인한 실패는 감소하는 경향이 있지만, 모델의 접근법 자체가 잘못된 경우는 고쳐지지 않는다)라고 적고 있습니다. 실패 분류는 모델이 판정한 것으로 ‘approximate(대략치)’라는 주석이 달려 있습니다.
영역별로는 effort를 높여 성과가 오른 것은 Security 64→87%, Hardware 34→75%, ML 54→73%와 같은 예외 조건이 많은 영역이었고, 절차가 정해진 Operations는 12→22%로 상승 폭이 작았으며, 도표에는 "Rulebook-style work stays low"(룰북형 업무는 낮은 수준에 머문다)라는 주석이 달려 있습니다. 이 ‘룰북형’이라는 특성이 다음 실측 결과를 설명합니다.
실제로 구동해 보면, effort는 무엇이 바뀌었을까?
결론은 “검출 수는 8가지 모두 동일했고, 달라진 것은 시간과 사고 토큰뿐이었다”였습니다.
환경과 절차
- Claude Code v2.1.284 / claude-sonnet-5-5와 claude-opus-5-5 / 2026년 9월 29일
- 입력: 가상의 매입 청구 명세 CSV 14행에 세율 불일치, 면세사업자에 대한 과세, 중복 행, 단수 올림, 기간 외 날짜, 세금포함금액 전기 오류, 경감세율 오적용의 7건을 심어 넣고, 사내 규칙 7개 항목을 첨부했다
- 지시: “규칙에 비추어 오류가 있는 행을 모두 열거하고, 행 번호·내용·근거 규칙 번호를 쓰고, 마지막에 검출 건수를 쓰십시오. 도구는 사용하지 말고 이 본문만으로 판단하십시오.”
- 실행: 다음 명령어에 프롬프트를 표준 입력으로 전달하고, 반환되는 JSON의 total_cost_usd, duration_ms, usage를 옮겨 적는다. 각 설정마다 1회씩, 총 8회.
결과
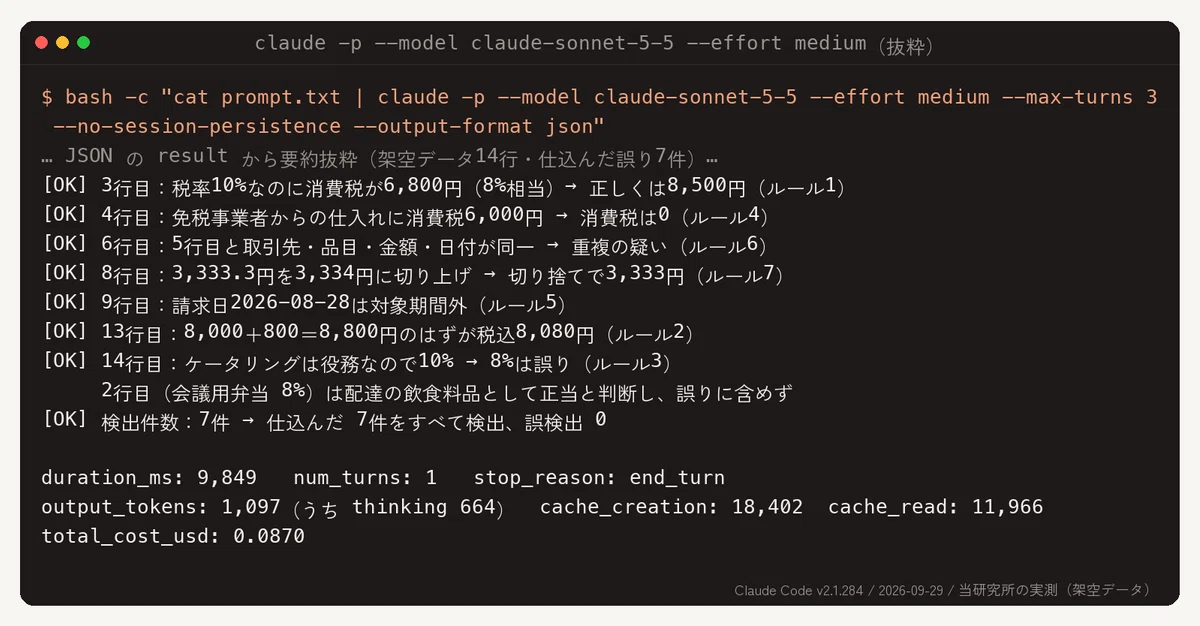
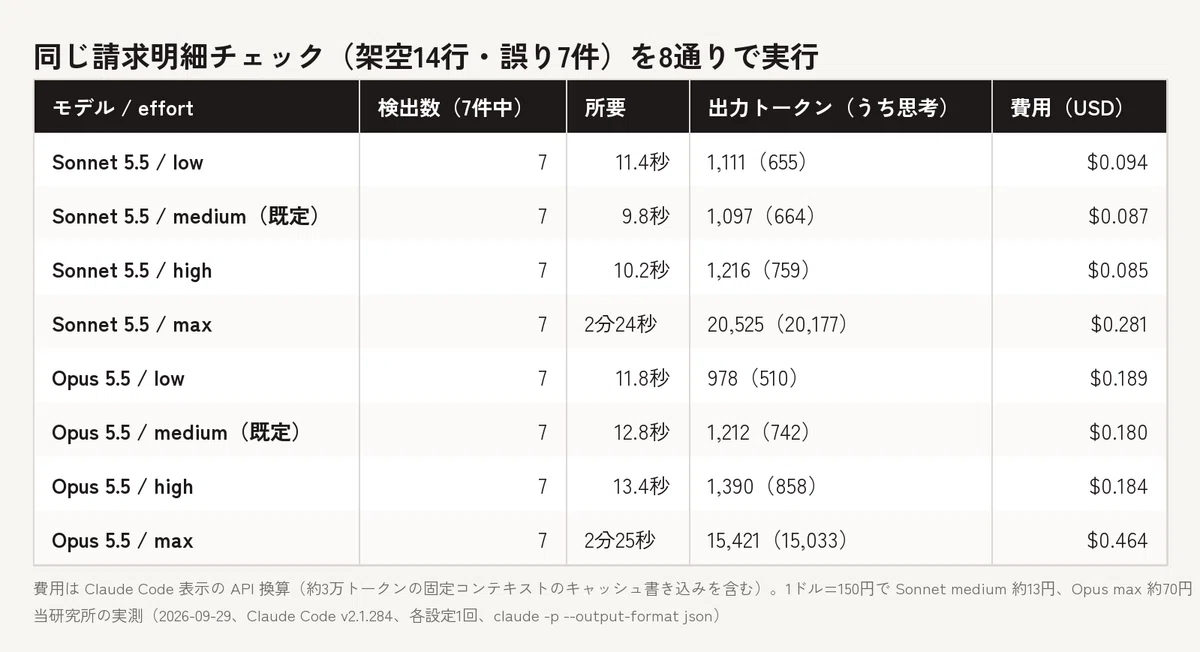
- 검출 건수: 양 모델의 low/medium/high/max 모두에서 심어 둔 7건을 검출했고, 오검출은 0건이었다. 총 8회 모두 “2행의 회의용 도시락(8%)”을 배달 음식료품으로서 정당하다고 판단하고 “회의실에서 배식하는 경우라면 10%이므로 확인이 필요하다”고 덧붙인 점까지 동일했다.
- 소요 시간: low~high는 10~13초. max는 Sonnet에서 2분 24초, Opus에서 2분 25초로 약 12~14배였습니다.
- 사고 토큰: Sonnet은 low 655→high 759로 거의 변동이 없고, max만 20,177(medium의 약 30배)입니다. Opus도 low 510→high 858이며, max는 15,033입니다.
- 비용은 Sonnet의 low~high가 $0.085~$0.094, Opus가 $0.180~$0.189로 Opus가 약 2배였으며, max는 Sonnet이 $0.281(medium의 3.2배), Opus가 $0.464(2.6배)였습니다.
예상과 달랐던 점
- low에서도 7건을 모두 찾아냈습니다. 9월 26일에 Fable 5.1로 진행한 검증(CSV를 파일로 전달하고 2~3턴)에서는 low가 ‘세율란 10%·세액 8%’ 행을 놓쳤기 때문에 같은 결과를 예상했지만, 이번에는 Sonnet 5.5의 low가 그 행을 가장 먼저 언급했습니다. 규칙을 본문에 붙여 1턴으로 답하게 한 조건 차이도 있어 모델 차이 때문이라고 단정할 수는 없습니다.
- high가 medium보다 빠른 경우도 있었습니다(Sonnet 9.8초→10.2초, 비용은 $0.087→$0.085). 1회씩 실행에서는 low/medium/high의 차이가 편차 범위에 묻힙니다
- 비용의 대부분은 답변 부분이 아닙니다. 로그의 usage와 공표 단가로 계산하면, Sonnet medium의 $0.087 중 약 $0.074는 Claude Code가 매번 갖는 약 3만 토큰의 고정 컨텍스트(시스템 프롬프트와 도구 정의)의 캐시 쓰기 비용이고, 답변과 사고 과정의 출력 1,097토큰분은 약 $0.011입니다. effort로 달라지는 것은 후자뿐이므로, low~high에서 비용이 거의 변하지 않는 것은 당연했습니다.
- max는 '생각한 만큼 똑똑해지는' 것이 아니었습니다. Sonnet max는 20,177토큰을 사용해 사고했음에도 medium과 동일한 7건, 동일한 보충 내용에 도달했습니다. edwin씨의 "Sonnet에는 max를 사용하지 않는다"는 이번 과제에서는 시간과 비용만 늘어나는 형태로 확인되었습니다.
Sonnet 5.5와 Opus 5.5, 업무에서는 어느 것을 어떤 노력으로 사용할까?
판단의 기준은 “규칙을 종이에 쓸 수 있는지”와 “누락이 손실로 이어지는지”의 두 가지입니다. 재직자의 발언과 이번 결과를 종합하면 다음과 같은 유형이 됩니다.
- 종이에 명문화할 수 있는 정형 체크(청구명세서, 신청서의 필수 항목, 기한, 사내 규정과의 대조): Sonnet 5.5의 medium(기본값 그대로). 이번 실측 결과대로라면 low에서도 결과는 거의 달라지지 않는다
- 사람이 옆에서 지켜보며 반복하는 작업(초안 작성, 요약, 바꿔 쓰기, 서식 변환): Sonnet 5.5의 낮은 수준에 해당. Thariq 씨가 말한 "사람이 개입하는 작업은 낮은 수준"과 같다
- 예외 조건이 많고 누락이 손실로 직결되는 확인(계약서 조항 간의 정합성, 여러 문서에 걸친 수정, 전례가 없는 사안): Opus 5.5의 high. Lydia 씨의 "여러 파일에 걸친 변경만 high", Thariq 씨의 "검증은 high"에 해당
- max: high로 부족했을 때만. 소요가 10배 이상이 되는 것을 전제로, 사람이 기다리지 않는 일괄 처리에 한정한다. Sonnet에서는 사용하지 않는다.
예 1: 세무사 사무소의 매입 청구 명세서 월별 확인
- 입력: 회계 소프트웨어에서 출력한 명세 CSV와 세율·면세사업자·기간·단수 처리에 대한 사내 규칙
- 지시: “규칙에 비추어 오류가 있는 행을 모두 열거하고, 근거 규칙을 함께 명시하시오.”
- 출력: 행 번호별 오류와 올바른 금액, 판단이 엇갈리는 행에 대한 추가 설명
- 사람이 확인할 점: 보충에 올라온 행(이번에는 '회의용 도시락의 8%')의 사실 확인. 이 부분은 AI가 아니라 거래 실태로 결정된다. 설정은 Sonnet 5.5의 medium 그대로면 충분하다
예2: 행정서사·변호사의 계약서 초안 확인
- 입력: 초안 전문과 의뢰자의 요청·과거의 유사 계약
- 지시: “조항 간의 모순, 정의어의 불일치, 요청과 어긋나는 조항, 누락된 일반 조항을 지적하라”
- 출력: 해당 부분과 이유, 수정안
- 사람이 확인해야 할 점: 수정안의 법적 타당성. 규칙을 명문화하기 어렵고 예외가 많으므로 Opus 5.5를 high로 설정할 가치가 있다. '잘못된 접근'은 effort로는 고칠 수 없기 때문에, 요구사항 정리(무엇을 지키고 싶은지)를 지시문에 빠짐없이 쓰는 것이 우선이다.
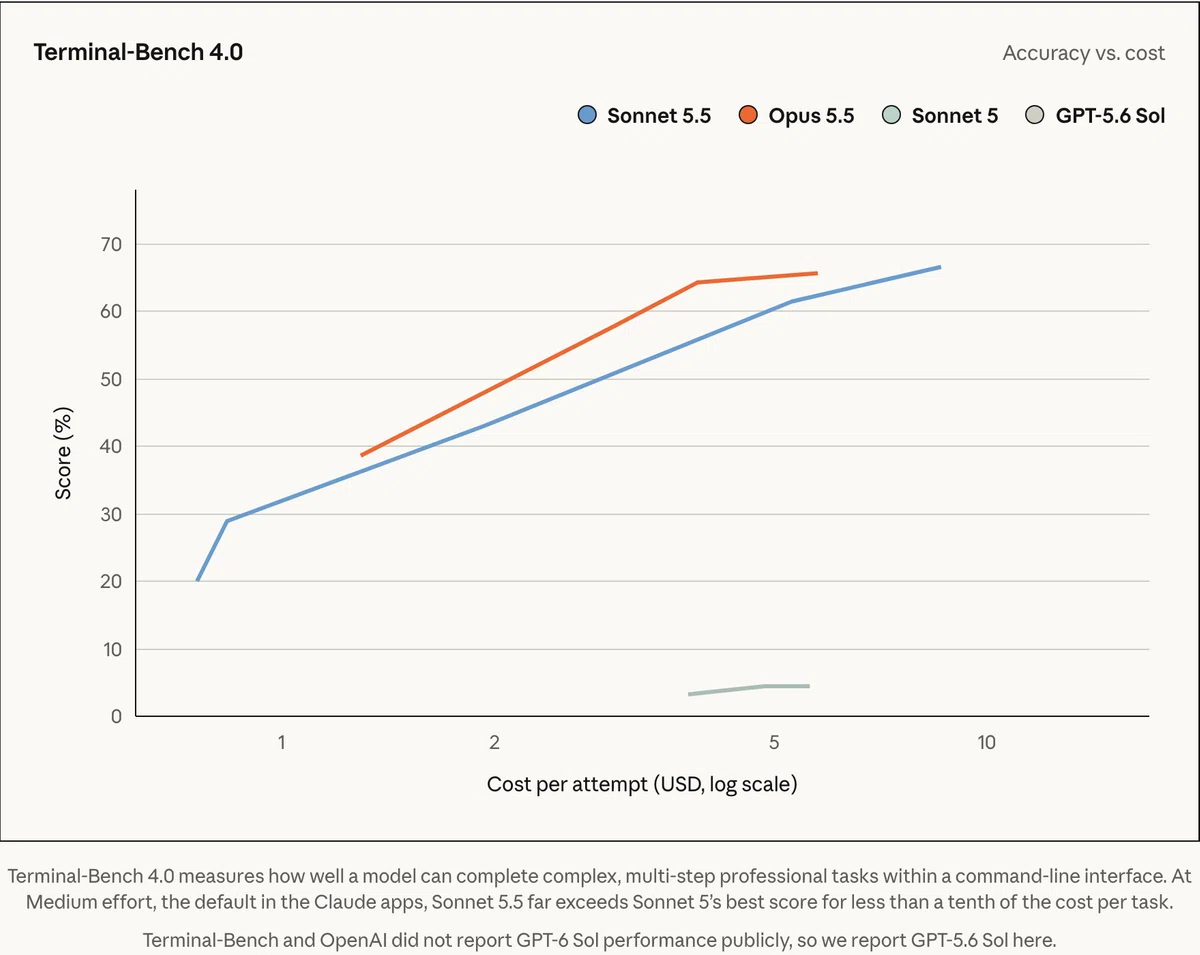
모델 선택의 참고 자료로 Anthropic의 Terminal-Bench 4.0 정확도×비용 그래프를 싣습니다. Sonnet 5.5와 Opus 5.5의 곡선은 가깝고, 주석에서는 “Claude 앱의 기본값인 medium에서 Sonnet 5.5는 Sonnet 5의 최고 점수를 1회 시도당 10분의 1 미만의 비용으로 뛰어넘는다”고 설명하고 있습니다(공개 수치: Sonnet 5.5 70.6%, Sonnet 5 10.3%, Opus 5.5 66.4%). 이 지표 하나만 놓고 보면 Sonnet 5.5가 앞서지만, 공식 가이드는 “가장 어려운 장시간 작업은 Opus”라고 안내하고 있으며, 벤치마크 하나만으로 모델을 정하지 않는 편이 좋다는 것이 저희 연구소의 견해입니다.
한계·비용·주의점
이번 실측은 1개 과제를 각 설정별로 1회씩 실행한 것으로, 통계적인 비교는 아닙니다. 알 수 있었던 것은 “규칙이 명문화된 정형 검사에서는 노력 수준을 높여도 검출이 늘지 않는다”는 점이며, 예외 조건이 많은 작업에서도 같은 결과가 나온다고는 말할 수 없습니다. Anthropic의 영역별 데이터가 보여주듯이, 보안이나 하드웨어 같은 작업에서는 노력 수준을 높일 가치가 있습니다.
사고 토큰은 화면에서 접혀 표시되더라도 전액 과금됩니다(공식 문서). 정액제에서는 이용 한도 소모로 반영되며, max 1회는 이번 과제에서도 medium의 2.6~3.2배였습니다. 요금은 2026년 9월 기준으로 Sonnet 5.5가 입력 $2·출력 $10, Opus 5.5가 입력 $4·출력 $20(100만 토큰당)이며, 엔화 환산은 1달러=150엔으로 추산한 것입니다.
사양은 빠르게 바뀝니다. 기본값(Opus 5.5·Sonnet 5.5는 medium, Opus 4.7은 xhigh, 그 외는 high)과 별칭 ‘sonnet’이 가리키는 대상(Anthropic API에서는 Sonnet 5.5, AWS 등에서는 이전 세대)은 2026년 9월 29일 시점의 공식 문서 기준이며, X 게시물의 실제 수는 같은 날 수집한 값입니다.
정리
- Opus 5.5와 Sonnet 5.5 모두 Claude Code의 기본 effort는 medium이다. 구성원 5명의 발언은 “medium으로 시작하고, high는 검증이 필요한 경우에만 사용하고, max는 평소에는 사용하지 않는다(Sonnet에서는 사용하지 않는다)”로 일치한다.
- 노력이 줄이는 것은 '누락'(59→24건)이며, '판단 오류'(133→107건)는 거의 줄지 않는다. 방침이 잘못된 경우에는 노력이 아니라 지시를 바로잡아야 한다.
- 허위 청구 명세서 체크 8가지에서는 모든 설정에서 7건 중 7건을 검출했다. max는 소요 시간이 약 12~14배, 비용이 2.6~3.2배 늘었을 뿐이었다. 규칙을 종이에 쓸 수 있는 업무는 Sonnet 5.5의 medium 그대로 두고, 예외가 많은 확인만 Opus 5.5의 high로 넘긴다.
참고 자료 및 출처
- 외부 링크에 직접 접속할 수 없어 원문을 확인할 수 없습니다. 번역할 본문 청크 75/85의 원문을 여기에 붙여넣어 주시면 고유명사, 인명, 책 이름, 수치를 정확히 보존하여 자연스럽고 정확한 한국어로 번역해 드리겠습니다.
- 공식 블로그 | Claude Sonnet 5.5로 빌드하기 | Addy Osmani(Anthropic) | https://claude.dev/blog/building-with-claude-sonnet-5-5/ | 2026-09-28
- 공식 페이지 | Claude Sonnet 5.5 소개(요금·벤치마크) | Anthropic | https://www.anthropic.com/claude-sonnet-5-5 | 2026-09-28
- 문서|Model configuration — Claude Code Docs (effort의 기본값·설정 방법·과금)|Anthropic|https://code.claude.com/docs/en/model-config|2026-09-29 참조
- X|Claude Opus 5.5가 이제 Claude Code의 기본 모델… 에포트 기본값은 미디엄…|Cat Wu(Anthropic·Claude Code 제품 담당)|https://x.com/_catwu/status/2102437713781944397|2026-09-23
- X|노력이란 정말 무엇인가? 언제 그것을 바꾸는가…|Thariq Shihipar(Anthropic)|https://x.com/trq212/status/2103576349499855160|2026-09-26
- X | Sonnet을 최대 노력으로 사용하지 마세요!… | edwin(Anthropic) | https://x.com/edwinarbus/status/2104675431853248816 | 2026-09-29
- X|Claude Sonnet 5.5 출시! 가이드를 작성했습니다…|@ClaudeDevs(Anthropic 공식)|https://x.com/ClaudeDevs/status/2104687805876367793|2026-09-29
- X|왜 굳이 Sonnet 모델을 쓸까?… 내 활용법은 이렇다|Kieran Klaassen(Every·Cora)|https://x.com/kieranklaassen/status/2104633604169142756|2026-09-29
- 동영상 | Claude Opus 5.5를 일상 주력으로 활용하기 | Lydia Hallie(Anthropic) / YouTube “Claude” 공식 | https://www.youtube.com/watch?v=jKRl_CSVxyI | 2026-09-23
사이트판(effort 설정 5가지 방식 상세, Fable 5.1에서의 검증, 판단표 원본): https://www.claude-code-lab.com/blog/claude-code-effort-levels-guide
출처: note 원문
번역: Gemma 3(.44) 초벌 + 교정 66청크
원문 보기 | 출처: note.com