
제목대로입니다. 시도한 동작 환경은 다음과 같습니다.
- RTX5060 TI (VRAM 16GB)
- Ubuntu 22.04LTS
- 메인 메모리 64GB
ComfyUI는 최신 버전을 사용합니다. 이 글의 작성 시점 당시 최신 버전은 v0.30.0이었습니다.
워크플로우
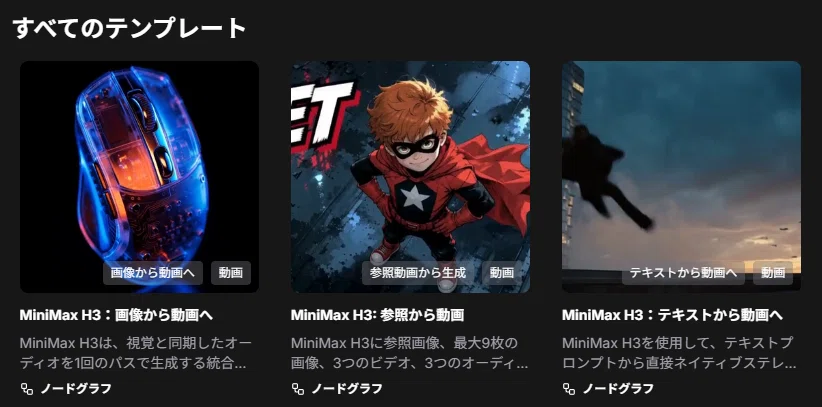
ComfyUI 템플릿의 “MiniMax H3: 참조에서 영상” 워크플로우를 거의 그대로 사용합니다.
기본 설정에서는 음성 입력 노드가 없으므로 “음성을 읽어들이는” 노드를 추가하고, 해당 노드의 오디오 출력을 MiniMax H3 Reference to Video 노드의 입력에 있는 ref_audio_0 핀에 연결합니다.

모델은 아래에서 다운로드 가능합니다.
참조 데이터 설정
참조 대상 이미지 및 음성은 아래와 같이 구성함을 전제로 합니다.
- ref_이미지 0의 선두 프레임 이미지를 입력하고 있습니다.
- 참고 오디오 0에 일본어로 된 노래 음성 데이터를 입력하고 있습니다.
영상 길이는 음성의 길이보다 약간 더 길게 설정합니다.
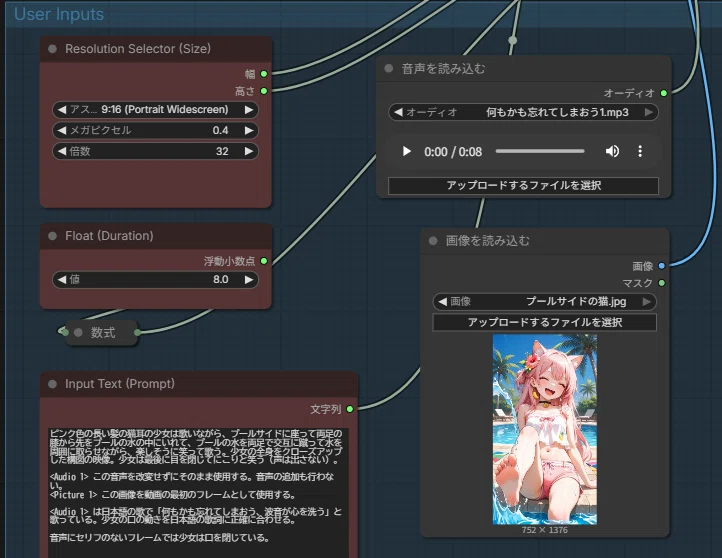
영상 길이는 “Float (Duration)”라고 표시된 노드로, 초 단위로 지정하며, 2.0초부터 10.0초까지 지정할 수 있습니다.
참고로, 입력 가능한 이미지 등의 수의 상한은 다음과 같습니다. (단, ComfyUI의 기본 워크플로우로는 이 상한까지 입력할 수 없으며, 약간의 수정이 필요합니다.)
- 이미지 정보 없음
- 영상: 3 클립 이하. 각 클립의 길이는 2~15초, 총 시간은 15초 이내.
- 음성: 3클립 이하. 음성은 이미지 또는 영상 입력과 병행되어야 하며, 단독 입력으로는 사용할 수 없습니다. 각 클립의 길이는 2초에서 15초 미만, 총 시간은 15초 이내입니다.
- 혼합 입력: 모든 입력 유형을 포함한 파일의 최대 수는 12입니다.
프롬프트
H3의 ref 모델용 프롬프트 작성 지침에 따라 프롬프트를 작성합니다. 지침 페이지는 아래에 있습니다.
일본 노래를 립싱크할 때, 최소한 다음과 같이 프롬프트를 작성해야 하는 것 같습니다.
- 오디오 1: 완전히 복사 - 이 오디오 1은 최종 영상의 완전한 최종 오디오 트랙을 1:1로 재사용한다.
- 그림 1은 샷 1의 첫 번째 프레임이다.
- 오디오 1은 일본 노래로 “○○○○○○○○”라고 부르고 있습니다. 캐릭터의 입 모양을 일본 가사에 정확하게 일치시킵니다.
이 덧붙여서 영상의 프롬프트를 작성합니다. “○○○○○○○○” 부분에는 노래 가사를 넣어주세요.
지역 비디오 생성 AI인 H3(MiniMax)로 립싱크를 간단히 테스트해 보았습니다. 단순히 음성과 이미지를 입력하는 것만으로는 효과가 없는데, 음성과 이미지를 하나씩 주었을 경우, 최소한 다음과 같이 프롬프트를 작성해야 합니다.
<Audio 1>의 음성을 그대로 사용하고, 음성의 변경이나 추가는 하지 않습니다… https://t.co/SyKcEq9RYk pic.twitter.com/DEpXC4mjbr— AI Bard Guild (@IsekaiBardGuild) 2026년 8월 6일
노래가 잘 들리지 않거나, 속도가 빠르거나 하는 음성으로는 제대로 진행되지 않을 수 있습니다.
프로ンプ트대로 지정하지 않더라도, 음성(노래 목소리)이 일부 수정될 수 있습니다. 생성된 영상 부분만 추출하여 원래 음성을 다시 적용하는 것이 더 나을 수 있습니다.
参考
출처: note 원문
번역: Gemma 3(.44) 초벌 + 교정 20청크
원문 보기 | 출처: note.com