Apple, 10배 큰 AI 모델보다 뛰어난 이미지 캡션 'RubiCap' 공개
게시판: 출판사 공지수집 | 작성자: admin | 작성일: 2026-03-26 08:50:46
Apple 연구팀이 기존 AI 모델보다 훨씬 작은 규모로도 더욱 정확하고 상세한 이미지 설명문을 생성하는 AI 모델 'RubiCap'을 개발했습니다.
### RubiCap: 이미지 캡션 생성을 위한 강화 학습 기반 프레임워크
RubiCap은 위스콘신-매디슨 대학교와 협력하여 개발된 고밀도 이미지 캡션 생성 AI 모델을 위한 새로운 프레임워크입니다. 고밀도 이미지 캡션은 이미지 전체를 요약하는 것이 아니라, 이미지 내의 각 영역에서 발생하는 사건들을 상세하게 설명하는 것을 목표로 합니다. 이를 통해 이미지 내 여러 요소와 영역을 식별하고 자세히 묘사함으로써, 전반적인 설명보다 훨씬 풍부한 장면 이해를 가능하게 합니다.
이러한 고밀도 이미지 캡션은 시각-언어 모델이나 텍스트 기반 이미지 생성 모델 학습 등 다양한 용도로 활용될 수 있습니다. 또한, 사용자 기능에 적용될 경우 이미지 검색이나 접근성 도구의 정확도를 향상시키는 데에도 기여할 수 있습니다.
### 기존 AI 모델의 한계와 RubiCap의 접근 방식
Apple 연구팀은 고밀도 이미지 캡션을 생성하는 AI 모델을 학습시키는 기존 AI 기반 접근 방식의 문제점을 지적했습니다.
* **높은 주석 비용:** 학습에 필요한 전문가 수준의 주석(annotation)을 대규모로 생성하는 데 막대한 비용이 발생합니다.
* **합성 캡션의 한계:** 강력한 시각-언어 모델로 생성된 합성 캡션을 활용하는 경우, 지도 학습(supervised learning)의 증류(distillation) 기법만으로는 출력의 다양성이 제한되고 일반화 성능이 낮아지는 문제가 있습니다.
* **강화 학습의 제약:** 강화 학습은 이러한 제약을 극복할 잠재력이 있지만, 기존에는 결과가 제한적이었고 개방형 캡션 생성에는 적용하기 어려웠습니다.
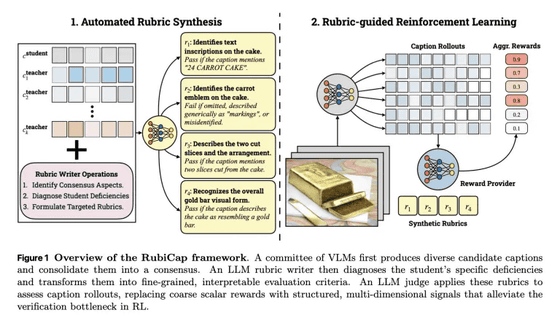
이에 Apple 연구팀은 새로운 프레임워크를 제안했습니다. 연구팀은 PixMoCap 및 DenseFusion-4V-100K라는 두 가지 학습 데이터셋에서 5만 장의 이미지를 무작위로 샘플링했습니다. 이후 Gemini 2.5 Pro, GPT-5, Qwen2.5-VL-72B-Instruct, Gemma-3-27B-IT, Qwen3-VL-30B-A3B-Instruct와 같은 대규모 언어 모델(LLM)을 사용하여 각 이미지에 대한 여러 캡션 후보를 생성했습니다. 동시에 RubiCap에게도 이미지에 대한 자체 캡션을 생성하도록 했습니다.
### RubiCap의 혁신적인 학습 과정
RubiCap은 Gemini 2.5 Pro를 활용하여 다음과 같은 과정을 거칩니다.
1. **캡션 비교 분석:** 각 모델이 출력한 캡션을 비교 분석합니다.
2. **강점 및 약점 파악:** 모델별로 우수한 점과 부족한 점을 특정합니다.
3. **평가 기준 수립:** 이를 바탕으로 캡션을 평가하기 위한 명확한 기준을 생성합니다.
이후 Qwen2.5-7B-Instruct를 심사위원으로 사용하여, 3단계에서 생성된 기준에 따라 AI 모델이 생성한 캡션을 채점하고 학습에 사용될 보상 신호를 생성합니다.
이러한 과정을 통해 RubiCap은 수정해야 할 부분에 대해 더욱 정확하고 구조화된 피드백을 받을 수 있게 되었으며, 단일한 '정답'에 의존하지 않고도 더 높은 정확도의 캡션을 생성할 수 있게 되었습니다.
RubiCap이 우수한 캡션을 생성하기 위한 피드백 루프를 나타낸 그림입니다.
### RubiCap의 성능 및 결과
최종적으로 Apple 연구팀은 파라미터 크기가 다른 RubiCap-2B, RubiCap-3B, RubiCap-7B의 세 가지 모델을 개발했습니다. 기존 AI 모델과 생성 캡션의 정확도를 비교하기 위한 이미지 캡션 벤치마크 테스트를 수행한 결과, RubiCap-3B(검정색)는 경쟁 AI 모델보다 뛰어난 성능을 보였습니다.
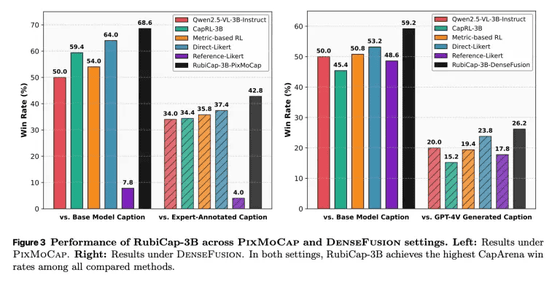
CapArena에서 RubiCap은 지도 학습 증류 모델, 기존 강화 학습 모델, 인간 전문가 주석 모델, GPT-4V를 능가하는 점수를 기록했습니다. CaptionQA에서도 뛰어난 단어 효율성을 보여주었으며, 가장 큰 파라미터 크기를 가진 RubiCap-7B는 더 큰 파라미터 크기를 가진 Qwen2.5-VL-32B-Instruct와 동등한 성능을 발휘했습니다. 특히 주목할 점은, 소형 모델인 RubiCap-3B를 캡션 생성기로 사용할 경우, 자체 모델로 생성된 캡션으로 학습된 시각-언어 모델보다 강력한 사전 학습된 시각-언어 모델을 생성할 수 있다는 것입니다.
블라인드 테스트에서 RubiCap-7B는 파라미터 크기가 720억 개 또는 320억 개인 최첨단 AI 모델과 비교했을 때도 가장 우수한 캡션을 생성하는 것으로 평가받았습니다. 또한, 환각(hallucination) 현상을 일으킬 확률이 가장 낮고 캡션 정확도도 가장 높은 것으로 나타났습니다.
---
**기사 이미지:**




---
**원문**: [Appleが10倍大きなAIモデルよりも優れた画像キャプションを付けられる「RubiCap」を発表](https://gigazine.net/news/20260326-apple-ai-captions-images-rubicap/)
**출처**: GIGAZINE (2026-03-26)
**번역**: AI 자동 번역